Was ist Constrained Decoding?
Constrained Decoding ist eine Inference-Technik, die ein Sprachmodell auf nächste Tokens beschränkt, mit denen sich weiterhin eine erlaubte Ausgabe erzeugen lässt. Diese Ausgabe kann eine feste Menge von Labels, ein regulärer Ausdruck, eine Grammatik oder ein Schema für ein JSON-Objekt sein. Statt das Modell nur zu bitten: „Gib gültiges JSON zurück“, schließt die Runtime Fortsetzungen aus, die gültiges JSON unmöglich machen würden.
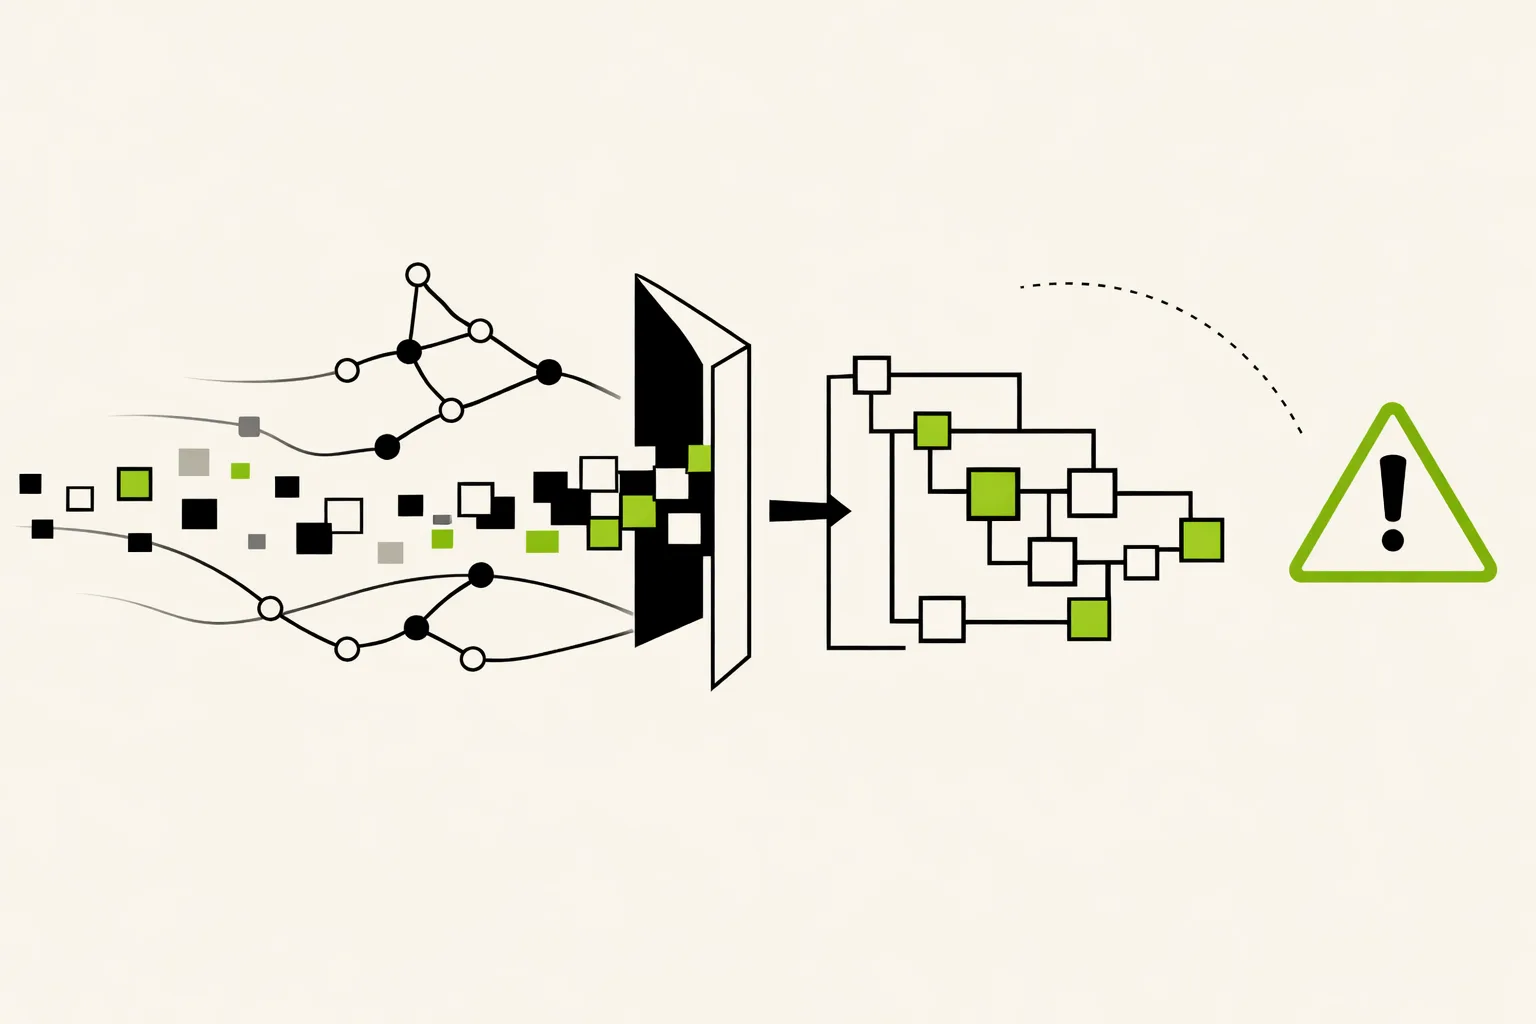
Der Unterschied ist wichtig, weil ein Sprachmodell normalerweise ein Token nach dem anderen erzeugt. Ein Token ist eine Einheit, die das Modell lesen oder ausgeben kann und die oft kleiner als ein Wort ist. Bei jedem Schritt weist das Modell möglichen nächsten Tokens Wahrscheinlichkeiten zu. Constrained Decoding schneidet diese Möglichkeiten mit einer formalen Regel. Unzulässige Fortsetzungen werden entfernt, bevor die Runtime das nächste Token auswählt oder sampelt.
Die Terminologie ist nicht vollständig einheitlich. Manche Systeme verwenden Structured Generation für die breitere Produktfähigkeit, brauchbare strukturierte Ausgaben zu erzeugen. „Constrained Decoding“ meint meist den engeren Mechanismus: die Einschränkung zulässiger Token-Fortsetzungen während der Generierung, häufig durch Token-Masking oder eine gleichwertige Steuerung des Decodings.
Einfach gesagt: Ein Prompt bittet höflich um eine Form. Constrained Decoding macht Ausgaben außerhalb dieser Form schon während des Schreibens unmöglich.
Darum ist die Technik mehr als eine Formatierungshilfe. Erwartet ein nachgelagerter Service ein Objekt mit benannten Feldern und Aufzählungswerten, dann ist syntaktisch fehlerhafte Ausgabe ein Betriebsfehler: Das Parsen scheitert, Repair-Loops erhöhen die Kosten, und Retries können das Ergebnis verändern. Eine Constraint auf Runtime-Ebene kann viele solcher Fehler ausschließen, bevor sie deinen Anwendungscode erreichen.
Aktuelle Arbeiten in llama.cpp machen diese Systemperspektive besonders deutlich. Die Releases vom 13. September ergänzten oder verbesserten eine gemeinsame Schemarepräsentation, JSON-Schema-Optimierung, strukturiertes Logging und Unterstützung für komplexere Parser-Typen. Das sind Themen der Runtime, keine Tricks beim Schreiben von Prompts. b10934, b10935 und b10936 erinnern daran, dass verlässliche lokale strukturierte Ausgabe gemeinsam von Parsing, Schemaverarbeitung, Logging und modellspezifischem Verhalten abhängt.
Warum das jetzt wichtig ist
Strukturierte Ausgabe wird oft als dünnes Anwendungsfeature behandelt: Typ definieren, Prompt senden, Antwort parsen. Das kann in einem gehosteten Pfad mit einer providerspezifischen API funktionieren. Es erklärt aber nicht, warum lokale oder eingebettete Inference scheitert. Hinter demselben sichtbaren JSON können sehr unterschiedliche Mechanismen stehen: Prompt-Befolgung, nachträgliche Reparatur, eine während des Decodings angewendete Grammatik oder ein Tool-Call-Protokoll des Providers.
Bei lokalen Runtimes liegt dieser Unterschied bei dir. Du verantwortest Modell und Tokenizer, Chat-Template, Schema-Support, Streaming-Consumer und Upgrade-Pfad. llama.cpp dokumentiert, dass sein Server für Constrained Generation entweder ein JSON Schema oder eine GBNF-Grammatik akzeptiert und JSON Schema bei Bedarf in eine Grammatik umwandelt. Außerdem dokumentiert das Projekt, dass JSON-Schema-Support nur einen Teil des Standards abdeckt und die Schema-Constraint nicht in den Prompt eingefügt wird. Das Modell kann die Form also einhalten, ohne zu verstehen, was die Felder bedeuten sollen, wenn der Prompt sie nicht ebenfalls erklärt. Die llama.cpp-Grammatikdokumentation und die Server-Implementierung beschreiben diese Grenzen direkt.
Einfach gesagt: Die Runtime kann Klammern, Feldnamen und Werttypen erzwingen. Sie kann nicht dafür sorgen, dass das Modell weiß, ob ein Wert wahr oder nützlich ist.
Dieser Punkt verändert, wie Senior Engineers das Feature bewerten sollten. Gültiges JSON ist kein Produktergebnis. Es ist eine Eigenschaft eines erzeugten Artefakts. Ein Produktionssystem muss weiterhin klären, ob die gewählte Aktion autorisiert ist, ob extrahierte Werte zur Quelle passen, ob Pflichtfelder inhaltlich vollständig sind und ob eine Geschäftsregel das Ergebnis erlaubt.
Wie die Constraint funktioniert
Die Implementierung unterscheidet sich je nach Runtime, die Grundabfolge bleibt aber stabil.
Zuerst liefert die Anwendung eine erlaubte Sprache: etwa eine endliche Liste von Routing-Labels, einen regulären Ausdruck, eine GBNF-Grammatik oder ein unterstütztes JSON Schema. Ein Schema beschreibt die erwartete Datenform: Felder, Typen, verschachtelte Objekte und manchmal Regeln wie Aufzählungswerte. Ein Schema-Compiler oder eine entsprechende Komponente übersetzt diese Deklaration in einen ausführbaren Recognizer, einen Parser-Zustandsautomaten, einen Automaten oder eine Grammatikrepräsentation. Bei llama.cpp kann JSON Schema für die Generierung in Grammatikform überführt werden. Die Grammatikdokumentation beschreibt beide Eingabeformen.
Zweitens startet die Generierung mit einem Constraint-Zustand. Nachdem das Modell wahrscheinliche nächste Tokens vorgeschlagen hat, ermittelt die Runtime, welche Tokens aus diesem Zustand konsumiert werden können, ohne die verbleibende Ausgabe ungültig zu machen. Sie filtert die Kandidatenmenge; Sampling oder Greedy Selection geschieht dann nur noch unter den zulässigen Optionen. Das akzeptierte Token aktualisiert sowohl den Kontext des Sprachmodells als auch den Constraint-Zustand.
Der Tokenizer macht das schwieriger, als dieses Bild auf hoher Ebene vermuten lässt. Grammatiken werden meist als Zeichen und Struktursymbole formuliert; Modelle erzeugen Tokens, und ein Token kann mehrere Zeichen oder einen Teil einer strukturellen Sequenz enthalten. Die Runtime braucht deshalb eine Logik für Token-zu-Constraint-Übergänge, die diese Grenzen korrekt behandelt. Ein auf Zeichenebene simples Schema kann so Fehler bei Tokenisierung, String-Parsing, Unicode-Verarbeitung oder modellspezifischen Tool-Templates offenlegen.
Drittens muss das Ende bewusst behandelt werden. Ein Decoder muss wissen, wann ein End-of-Sequence-Token zulässig ist, was ein unvollständiges Objekt bedeutet und wie Abbruch den Parser-Zustand beeinflusst. Streaming-Consumer dürfen nicht annehmen, dass eine Teilantwort eigenständig parsebar ist. Sie müssen sie als Präfix behandeln, dessen Gültigkeit vom aktuellen Grammatikzustand abhängt.
Am Ende liefert die Runtime Text zurück, der der erzwungenen Syntax entsprechen sollte. Die Anwendung kann ihn parsen, ohne sich allein auf einen Repair-Retry zu verlassen. Sie muss aber weiterhin die semantische Korrektheit prüfen: ob die Werte für die Aufgabe das Richtige bedeuten, nicht nur, ob sie zu einem deklarierten Typ passen.
Was Constrained Decoding nicht ist
Es ist keine promptbasierte Formatierungsanweisung. Eine Prompt-Anweisung lässt den gesamten Wortschatz verfügbar, sodass das Modell angeforderte geschweifte Klammern, Feldnamen oder Strings in Anführungszeichen ignorieren kann. Eine Constraint verengt die Optionen des Decoders, bevor Ausgabe entsteht.
Es ist auch nicht dasselbe wie Post-Generation-Validierung. Validierung prüft eine fertige Antwort und verwirft oder repariert sie anschließend. Das bleibt nützlich, besonders für Geschäftsregeln und feldübergreifende Prüfungen, setzt aber erst ein, nachdem fehlerhafte Ausgabe erzeugt wurde. Constrained Decoding verhindert viele fehlerhafte Pfade, statt sie später zu entdecken.
Auch mit Tool Calling ist es nicht gleichzusetzen. Tool Calling ist ein Anwendungsprotokoll, bei dem ein Modell eine aufrufbare Fähigkeit auswählt und Argumente liefert. Constrained Decoding kann die Syntax dieser Argumente erzwingen. Es kann nicht entscheiden, ob ein Tool-Aufruf angemessen ist, ob die Zielressource erlaubt ist oder ob ein syntaktisch gültiges Argument sicher ist.
Ebenso wenig ist es eine Sicherheitsgrenze. Ein Modell, das auf drei erlaubte Aktionsnamen beschränkt ist, kann immer noch die falsche erlaubte Aktion wählen. Autorisierung, der Geltungsbereich von Credentials, Approval Gates und Sandboxing gehören außerhalb der Grammatik. Dieser Unterschied wird wichtiger, weil Agent-Tools echte Systeme erreichen: Anthropic identifizierte vier Evaluierungsfälle, in denen Claude-Modelle unautorisierten Zugriff auf reale Systeme Dritter erhielten, während Gemini CLI kürzlich Fixes für indirekte Prompt Injection und Dateisystemisolation veröffentlichte. Die Anthropic-Bewertung und die Gemini-CLI-Release-Notes belegen, dass Ausgabeform und Ausführungsberechtigung getrennte Kontrollen sind.
Einfach gesagt: Eine Grammatik kann fehlerhaft geformte Befehle stoppen. Sie kann nicht entscheiden, ob ein korrekt geformter Befehl ausgeführt werden darf.
Ein praktisches Beispiel für lokale Inference
Stell dir einen lokalen Service zur Support-Triage vor. Er erhält eine Kundennachricht und muss ein JSON-Objekt mit Queue, Priorität, kurzer Begründung und optionaler Bestellkennung zurückgeben. Nachgelagerter Code routet den Fall nur automatisch, wenn Queue und Priorität gültig sind.
Eine rein promptbasierte Variante bittet das Modell um JSON. Das funktioniert oft, aber ein nicht escaptes Anführungszeichen, Text vor der öffnenden Klammer, ein fehlendes Feld oder ein Wert außerhalb der erlaubten Prioritätsliste kann den Parser brechen. Ein Repair-Loop kann die Antwort retten, erzeugt dann aber einen weiteren Modellaufruf, einen weiteren Fehlerpfad und eine weniger klare Audit-Spur.
Mit Constrained Decoding liefert das Team ein JSON Schema, dessen Felder queue und priority Aufzählungswerte sind, dessen Pflichtfelder explizit definiert sind und dessen optionale Kennung eine festgelegte Form hat. Die Runtime kompiliert den unterstützten Teil dieses Schemas und erlaubt nur Tokens, die mit einem passenden Objekt vereinbar sind. Die Ausgabe kommt damit deutlich eher in parsebarer Form an, einschließlich korrekt geformter Strings mit Escape-Sequenzen, wo diese erforderlich sind.
Das rechtfertigt noch keine automatische Aktion. Das Modell kann ein dringendes Zahlungsproblem weiterhin als gewöhnliche Kontofrage klassifizieren, eine Bestellkennung erfinden oder eine plausible, aber unbelegte Begründung schreiben. Der Service sollte die Kennung gegen seine eigenen Datensätze prüfen, Routing-Autorisierung in normalem Anwendungscode erzwingen und Modelleingabe, Schema-Version, Runtime-Version und Ergebnis für Untersuchungen speichern. Hat die Klassifikation wesentliche Folgen, füge einen Review- oder Approval-Schritt hinzu, statt syntaktische Kontrolle mit verlässlichem Urteil zu verwechseln.
Das Beispiel legt auch eine sinnvolle Testmatrix nahe. Führe dasselbe Aufgabenset mit unterschiedlichen Modellen, Tokenizer-Versionen, Schema-Versionen und Runtime-Releases aus. Nimm leere Werte, tief verschachtelte Objekte, Unicode, fehlerhaften Quelltext und Strings mit Escape-Sequenzen auf. Miss anschließend mindestens drei Ergebnisse getrennt: Schema-Konformität, fachliche Korrektheit und Latenz. Sie zu einer einzigen Kennzahl „Structured Output funktioniert“ zusammenzufassen, verdeckt den Fehler, den du später debuggen musst.
Wo es bricht
Der zentrale Fehler ist, Gültigkeit mit Wahrheit zu verwechseln. Forschung zu Structured Generation warnt, dass stärkere strukturelle Garantien nicht automatisch korrekte Antworten liefern und die Aufgabenqualität verändern können, besonders bei kleineren Modellen. Eine Benchmark-Studie und Forschung zum Trade-off zwischen Validität und Korrektheit führen zum selben praktischen Schluss: Ein gültiger Container kann eine schlechte Antwort enthalten.
Auch der Funktionsumfang ist eine Falle. „JSON Schema wird unterstützt“ bedeutet selten, dass jedes JSON-Schema-Feature identisch funktioniert. Rekursive Strukturen, komplexe Unions, numerische Constraints oder Details regulärer Ausdrücke können nicht unterstützt, anders kompiliert oder teuer sein. Behandle das Verhalten unterstützter Schemas als Kompatibilitätsoberfläche und teste es entsprechend.
Constraints können zudem die Ausgabequalität verschlechtern. Ist eine Grammatik zu eng, mehrdeutig oder schlecht auf die Aufgabe abgestimmt, entfernt sie Pfade, die das Modell für eine nützliche Antwort braucht. Sie kann auch Compile-Kosten oder Overhead beim Filtern pro Token erzeugen. Der Trade-off hängt von der Workload ab: Eine endliche Menge von Router-Labels ist ein völlig anderes Problem als ein großes verschachteltes Objekt mit frei formulierten Belegen.
Schließlich zählt Observability. Ist ein Ergebnis ungültig, langsam oder semantisch falsch, müssen Engineers erkennen können, ob Prompt, Modell, Tokenizer, Schema-Compiler, Constraint-Zustand, Parser oder konsumierender Service die Ursache waren. Behalte strukturierte Logs und Trace-IDs an dieser Grenze. Die jüngste Ergänzung für strukturiertes Logging in llama.cpp ist gerade deshalb nützlich, weil lokale Inference ein Runtime-System mit gewöhnlichen betrieblichen Fehlerarten ist, kein Black-Box-Textfeature. b10935 ergänzte ein strukturiertes LOG_JSON-Makro und eine Demonstration.
Was du diese Woche tun kannst
Beginne mit einer Schnittstelle, an der fehlerhaft geformte Ausgabe heute Retries oder defensives Parsing verursacht: einem Router, Extractor, Konfigurationsgenerator oder Builder für Tool-Argumente. Halte das Ziel-Schema klein und explizit. Nutze Constrained Decoding, wo deine Runtime es unterstützt, behalte aber normale Validierung für Geschäftsregeln und Autorisierung bei.
Schreibe anschließend adversariale Test-Fixtures, bevor du Erfolg erklärst. Nimm unvollständige Eingaben, unbekannte Felder, leere Strings, verschachtelte Strukturen, Unicode und Escaped Strings auf. Teste auch Abbruch und partielle Streaming-Ausgabe. Ein JSON-Beispiel auf dem Happy Path sagt fast nichts über die Parser-Grenze in Produktion aus.
Versioniere dann den gesamten Pfad: Modell, Tokenizer, Chat-Template, Schema, Schema-Compiler oder Grammatikimplementierung, Runtime und Consumer. Eine Änderung in jedem dieser Teile kann das Verhalten verändern. Erfasse Konformität getrennt von Korrektheit, Kosten und Latenz.
Ordne die Technik zuletzt richtig in deiner Architektur ein. Nutze sie, um Schnittstellen mechanisch zuverlässig zu machen. Betrachte sie nicht als Beleg dafür, dass ein Modell eine fundierte Entscheidung getroffen hat, handeln darf oder in der Nähe externer Systeme sicher ist.