Protokoll-Statelessness bedeutet nicht „kein State“
Protokoll-Statelessness ist eine Designvorgabe: Ein Server muss einen Request verstehen und verarbeiten können, ohne versteckten Gesprächskontext aus einer Protokoll-Session auf einer bestimmten Maschine wiederherzustellen. Der Request enthält, was das Protokoll braucht, oder verweist explizit auf dauerhaften State an anderer Stelle.
Gerade der zweite Teil ist wichtig. „Stateless“ wird oft fälschlich als „die Anwendung speichert nichts“ verstanden. Für die meisten Systeme wäre das weder realistisch noch sinnvoll. Bestellungen, Nutzerkonten, lang laufende Jobs, Freigaben und Agent-Workflows haben State. Protokoll-Statelessness stellt eine engere Frage: Hängt dieser Request von privatem Protokollkontext ab, der an eine Verbindung, einen Prozess oder eine Sticky-Route des Load Balancers gebunden ist?
Einfach gesagt: Ein stateless Protokoll vergisst deinen Workflow nicht. Es versteckt dessen Kontext nur nicht mehr im Session-Speicher eines einzelnen Servers.
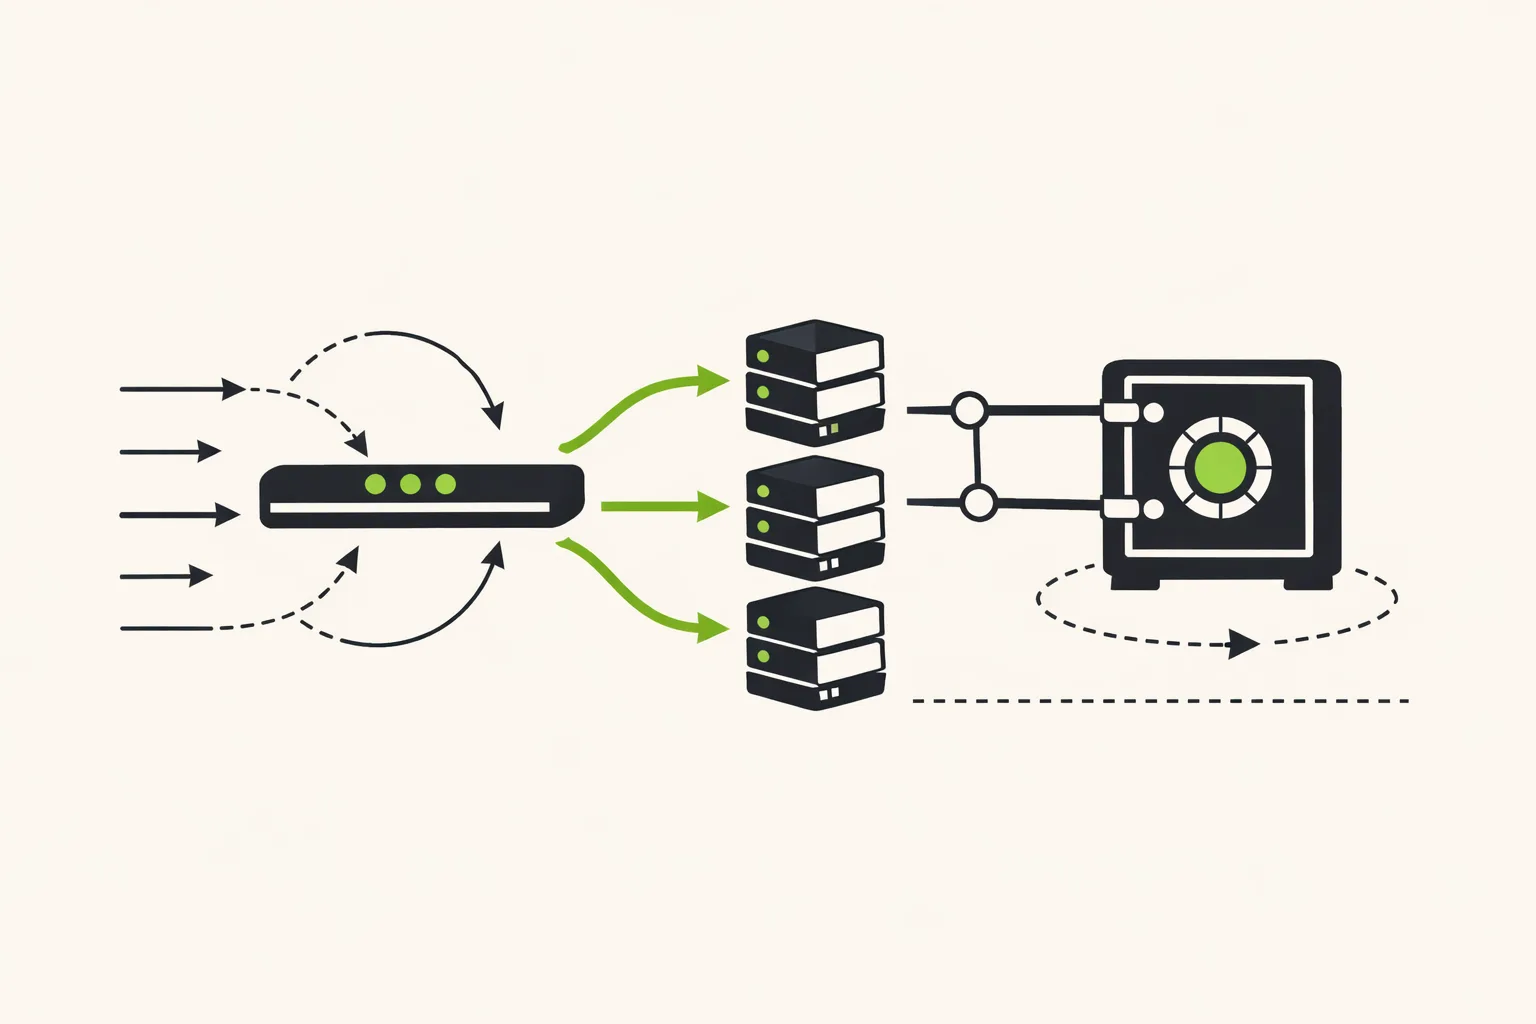
Bei MCP ist diese Unterscheidung aktuell. Die Revision vom 2026-07-28 entfernt den Austausch initialize/initialized und die Protokoll-Session Mcp-Session-Id aus dem neueren Streamable-HTTP-Wire-Format. Dadurch kann jede geeignete Serverinstanz einen MCP-Request bearbeiten, statt dass er auf Protokollebene an eine frühere Session-Route gebunden ist. MCP Release Candidate Anwendungs-State kann weiterhin über explizite Handles zwischen Aufrufen bestehen, die als normale Tool-Argumente übergeben werden.
Für Engineers, die entfernte MCP-Services bauen, ist das mehr als ein aufgeräumter Lifecycle. Es verschiebt Verantwortung. Der Edge besitzt Gesprächskontinuität nicht länger implizit. Das übernehmen deine dauerhaften Anwendungskomponenten: eine Datenbank, eine Workflow Engine, ein Object Store oder ein anderer maßgeblicher State-Service.
Warum das jetzt wichtig ist
Stateful Protokoll-Sessions lassen sich in frühen Systemen leicht skizzieren. Ein Client verbindet sich, handelt Capabilities aus, und der gewählte Prozess behält den folgenden Kontext. Diese Bequemlichkeit erzeugt aber stillschweigend Betriebsabhängigkeiten: Session Affinity, Session-Replikation, abgestimmtes Draining bei Deployments und Sonderlogik für den Fall, dass die ausgewählte Instanz verschwindet.
Eine Sticky Session bedeutet, dass ein Load Balancer einen Client wiederholt an dieselbe Backend-Instanz leitet. Das kann nützlich sein, bindet Verfügbarkeit und Skalierung aber an eine Route mit Historie. Ersetzt ein Autoscaler diese Instanz, muss das System die Session wiederherstellen, die Arbeit fehlschlagen lassen oder den Client neu beginnen lassen.
Ein Protokoll mit unabhängig interpretierbaren Requests passt natürlicher hinter gewöhnliches Layer-7-Load-Balancing und kurzlebige Compute-Umgebungen. HTTP ist stateless definiert, weil sich die Semantik eines Requests isoliert verstehen lässt; der Standard nennt ausdrücklich Vorteile für Proxy-Wiederverwendung und dynamisches Load Balancing. RFC 9110 Das löst verteilte Systemprobleme nicht auf magische Weise. Es entfernt aber einen unnötigen Ort, an dem sie sich verstecken können.
Die MCP-Revision ist damit ein Beispiel für ein breiteres Muster in der Agent-Infrastruktur: Transport und Routing sollen langweilig bleiben; Workflow-State soll explizit, dauerhaft, autorisiert und beobachtbar sein. Das ist besonders hilfreich, wenn viele Agents, Clients und Mandanten einen entfernten Tool-Service teilen und kein Worker nur deshalb bevorzugt wird, weil er einen früheren Request gesehen hat.
So funktioniert es: Versteckten Kontext in einen expliziten Vertrag überführen
Zuerst entscheidest du, was ein Request zur Verarbeitung benötigt. Häufig gehören dazu Authentifizierung, Mandantenidentität, das ausgewählte Tool, Argumente, eine Trace-ID und ein expliziter Verweis auf frühere Arbeit. Möglicherweise braucht der Request auch eine Versions- oder Capability-Auswahl, die zuvor einmalig beim Session-Handshake festgelegt wurde.
Danach verschiebst du Informationen zwischen Requests in einen maßgeblichen Store. Ein Workflow Record kann etwa Owner, aktuelle Phase, erlaubte Übergänge, Ergebnisse und Ablaufzeit eines Jobs enthalten. Der Request trägt nicht den ganzen Record, sondern eine undurchsichtige Kennung, ein explizites State Handle, mit der der Service ihn findet.
Dieses Handle musst du bei jeder Verwendung validieren. „Undurchsichtig“ bedeutet nicht „vertrauenswürdig“. Der Service muss feststellen, dass das Handle existiert, nicht abgelaufen ist, zum authentifizierten Mandanten gehört und den angefragten Übergang erlaubt. Ein Handle ist ein Verweis, keine Autorisierungsentscheidung.
Als Nächstes legst du das Retry-Verhalten einer Operation bewusst fest. Netzwerkfehler hinterlassen beim Client eine unangenehme, aber normale Unsicherheit: Vielleicht kam der Request nie an; vielleicht wurde er gerade abgeschlossen, bevor die Antwort verloren ging. Ein stateless Server kann sich nicht auf eine private Session verlassen, um diese Unsicherheit aufzulösen. Für Seiteneffekte gibst du der Operation einen Idempotency Key, also eine Kennung, mit der sich die Wiederholung desselben logischen Requests erkennen lässt. Speichere das Ergebnis oder den Outcome zu diesem Key und liefere bei einem legitimen Retry denselben Outcome zurück.
Einfach gesagt: Stateless Routing macht Retries leichter versendbar, aber nicht automatisch sicher. Sicherheit entsteht durch die Regeln der Operation für doppelte Ausführung.
Zum Schluss instrumentierst du die Request-Grenze. Eine Trace-ID pro Request, der authentifizierte Principal, die State-Handle-ID und die Operations-ID ermöglichen nützliche Fragen, ohne den Session-Speicher einzelner Prozesse durchsuchen zu müssen: Welcher Mandant hat diesen Workflow geändert, welcher Request hat es zweimal versucht, und welches Backend bearbeitete jeden Versuch?
Hier kommen auch Multi Round-Trip Requests ins Spiel. MCP beschreibt sie als Ersatz für mehrere serverinitiierte Request-Muster im stateless Betrieb. Client und Server können weiterhin eine mehrstufige Interaktion abschließen, aber jeder Schritt ist ein unabhängig routbarer Request statt eines Austauschs, der in einer Protokoll-Session verankert ist. MCP-Spezifikation
Was es nicht ist
Protokoll-Statelessness ist keine stateless Anwendung. Ein Shopping-Service kann auf Protokollebene stateless sein und trotzdem Inventar, Warenkörbe, Zahlungen und Audit-Historie behalten. Der Unterschied: Der Server für Request zwei braucht keinen privaten Speicher des Servers von Request eins. Er kann den notwendigen Business-State über einen expliziten Verweis und eine gemeinsame maßgebliche Instanz abrufen.
Sie ist auch nicht gleichbedeutend mit HTTP. Die stateless Semantik von HTTP erlaubt Anwendungen, Cookies, Bearer Tokens, serverseitige Sessions und Ressourcenkennungen darauf aufzubauen. HTTP verhindert versteckten State nicht; es bietet ein request-orientiertes Fundament, auf dem du ihn einführen oder vermeiden kannst.
Ebenso ist sie nicht dasselbe wie Idempotenz. Idempotenz beschreibt die Wirkung einer wiederholten Operation. Eine Operation wie Status auf approved setzen kann idempotent sein und dennoch eine stateful Protokoll-Session benötigen. Umgekehrt kann ein stateless Endpunkt Zahlung erstellen doppelte Abbuchungen erzeugen, wenn ihm Deduplizierung fehlt. Beide Konzepte tauchen oft zusammen auf, weil unabhängig geroutete Requests doppelte Zustellung und Retry-Unsicherheit nicht ignorierbar machen.
Und schließlich bedeutet sie nicht, dass jede Funktion sessionlos werden sollte. Das MCP C# SDK dokumentiert stateful Sessions für unaufgeforderte Benachrichtigungen, Resource Subscriptions und Isolation pro Client; zugleich bietet es einen hybriden Migrationsmodus. Dokumentation des MCP C# SDK Eine verbindungsgebundene Funktion kann einen stateful Mechanismus benötigen. Entscheidend ist, diesen Bedarf ehrlich zu benennen, statt eine Session aus Gewohnheit beizubehalten.
Ein praktisches Beispiel: ein entferntes Code-Review-Tool
Betrachte ein hypothetisches MCP-Tool, das ein Repository-Review startet und später Findings zurückgibt. In einem session-orientierten Design erzeugt der erste Request Review-Kontext im Arbeitsspeicher von Worker A. Spätere Requests setzen voraus, dass Worker A die Repository-Auswahl, die Policy und Teilergebnisse noch besitzt. Skalierung erfordert Affinity; nach einem Neustart muss dieser Kontext wiederhergestellt werden oder geht verloren.
Eine protokoll-stateless Variante macht den Workflow sichtbar. startReview erzeugt einen dauerhaften Review Record und gibt ein Handle zurück. Der Record bindet das Review an Mandant, Repository-Revision, ausgewählte Policy und Ablaufzeit. getReview erhält dieses Handle und liest den Record. applyFinding erhält Handle, Finding-Kennung und Idempotency Key.
Jeder gesunde Worker kann jeden Aufruf bedienen. Worker dürfen unveränderliche Repository-Daten zur Performance cachen, aber die Korrektheit hängt nicht vom Überleben des Cache ab. Der Workflow Store entscheidet, ob ein Finding existiert, ob es bereits angewendet wurde und ob der Aufrufer autorisiert ist. Ein Deployment kann Worker drainen, ohne Protokoll-Sessions zu migrieren, weil der Workflow nicht ihnen gehört.
Dieses Design hat Kosten. Jeder Request validiert das Handle und benötigt möglicherweise einen Storage-Lookup. Du musst Laufzeiten und Widerrufsverhalten für Handles festlegen. Gibt das Tool sensible Ergebnisse zurück, musst du sicherstellen, dass ein geratenes, geleaktes oder mandantenübergreifend verwendetes Handle sie nicht abrufen kann. Das sind aber wertvolle Kosten: Sie beschreiben die tatsächlichen Sicherheits- und Konsistenzanforderungen, die die implizite Session zuvor verborgen hat.
Wo es scheitert
Der häufigste Fehler ist, State auszulagern, ohne seinen Lifecycle zu definieren. Eine Datenbankzeile, die nie abläuft, ist kein Workflow-Design. Definiere Erzeugung, erlaubte Übergänge, Timeout, Abbruch, Aufbewahrung und Löschung. Entscheide, was geschieht, wenn zwei Requests gleichzeitig unvereinbare Übergänge versuchen. Die dauerhafte maßgebliche Instanz muss diese Regeln durchsetzen, nicht nur Ereignisse im Nachhinein speichern.
Ein weiterer Fehler ist, ein Handle wie ein Bearer Credential zu behandeln, ohne es so zu benennen. Wenn Besitz eines Handles Zugriff gewährt, musst du es vor Logs, URLs, Telemetrie und versehentlicher mandantenübergreifender Wiederverwendung schützen. Dient es nur als Locator, fordere zusätzlich normale Autorisierung. In beiden Fällen validiert der Server Geltungsbereich und Ablaufzeit.
Wiederholte Metadaten sind ein echter Trade-off. Eine ausgehandelte Session kann verhindern, dass bestimmte Informationen erneut gesendet werden. Stateless Requests können mehr Bytes und Parsing-Zeit kosten. In vielen entfernten Agent-Systemen ist dieser Overhead das einfachere Fehlermodell wert, kostenlos ist er aber nicht. Miss ihn, wenn Latenz oder Request-Volumen relevant sind.
Auch für Subscriptions und serverinitiierte Aktivität gibt es keine allgemeingültige Antwort. Du kannst einen stateful Channel beibehalten, ein separates Benachrichtigungssystem aufbauen oder über einen dauerhaften Workflow Record explizit pollen. Die richtige Wahl hängt von Zustellgarantien und Produktanforderungen ab, nicht von einem Architekturslogan.
Einfach gesagt: Statelessness verschiebt Verantwortung, sie beseitigt sie nicht. Wenn ein Workflow Regeln, Retries, Owner und Ablaufzeiten hat, muss eine dauerhafte Komponente sie durchsetzen.
Was du diese Woche tun kannst
Zeichne zunächst den aktuellen Request-Pfad für ein entferntes Tool. Markiere jede Abhängigkeit von Prozessspeicher, Verbindungsidentität, ausgehandelten Session-Daten und Sticky Routing. Frage dann bei jedem Punkt: Ist das notwendiger Protokollkontext, eine cachebare Optimierung oder echter Anwendungs-State?
Wähle eine mehrstufige Operation und gib ihr einen expliziten Workflow Record. Nimm Mandantenbindung, Owner, Status, Ablaufzeit und Operationskennung auf. Ergänze den Seiteneffekt-Übergang um einen Idempotency Key. Teste die unangenehmen Fälle: doppelte Zustellung, verlorene Antwort nach Abschluss, Worker-Neustart zwischen Aufrufen und einen Aufrufer, der versucht, das Handle eines anderen Mandanten wiederzuverwenden.
Entferne als Nächstes Session Affinity in einer Nicht-Produktionsumgebung und führe dieselben Tests über mehrere Instanzen aus. Das Ziel ist nicht nur, dass Requests gelingen; der Audit Trail soll exakt erklären, was geschehen ist. Sorge dafür, dass dein Observability-System State Handle und Operations-ID korreliert, ohne sensible Werte offenzulegen.
Prüfe für MCP konkret, ob Clients und Server den neueren Streamable-HTTP-Lifecycle nutzen und ob eine Deployment-Annahme noch von Mcp-Session-Id abhängt. Lösche nicht einfach Session Storage. Ersetze zunächst jede berechtigte Nutzung durch expliziten State sowie Autorisierungs- und Retry-Semantik. Wenn du Subscriptions oder unaufgeforderte Benachrichtigungen brauchst, wähle die dokumentierte stateful oder hybride Option bewusst statt zufällig. Dokumentation des MCP C# SDK
Das Ergebnis ist keine Anwendung mit weniger State. Es ist eine Anwendung, in der State einen klaren Owner hat und ein Request verständlich bleibt, ohne einen bestimmten Server nach früheren Ereignissen zu fragen. Das ist ein besseres Fundament, um Agent-Infrastruktur zu skalieren – und um sie zu debuggen, wenn sich das Netzwerk so verhält, wie Netzwerke es nun einmal tun.