Die nützliche Bedeutung von Inference-Portabilität
Inference-Portabilität ist kein universell standardisierter Begriff. Manche Engineers verwenden ihn eng und meinen damit, dass sich eine Modelldatei auf mehreren Maschinen laden lässt. Andere meinen, dass eine Anwendung zwischen Accelerator-Backends wechseln kann, ohne ihre Integration zu ändern. Beide Verwendungen sind informell und für sich allein unvollständig.
In diesem Artikel ist Inference-Portabilität deshalb eine rigorose redaktionelle Definition: Du entwirfst den Inference-Stack so, dass ein Modellartefakt und der Inference-Vertrag auf Anwendungsebene über Hardware-Ziele, Ausführungs-Backends und Deployment-Umgebungen hinweg mit begrenzten Änderungen an der Anwendung funktionieren. Diese bewusst breite Definition umfasst die Modelldatei, die ausführende Runtime, die Serving-Schnittstelle und die betrieblichen Prüfungen darum herum. Sie verspricht nicht, dass Outputs, Geschwindigkeit, Kosten oder Zuverlässigkeit auf jedem Ziel gleich sind.
Das ist wichtig, weil eine KI-Anwendung selten nur an ein Modell gebunden ist. Sie hängt an einem Tokenizer, einem Gewichtsformat, Speicherlayouts, Kernels, Treibern, der Behandlung strukturierter Ausgaben, Logging und einer API für Clients. Nur die Gewichte zu verschieben, lässt meist den Rest dieser Abhängigkeitskette bestehen.
Einfach gesagt: Eine portable Modelldatei ist nützlich, aber nur ein Teil. Inference-Portabilität bedeutet, dass du die Maschine unter einem KI-Feature wechseln kannst, ohne das Feature um einen anderen Ausführungs-Stack herum neu zu bauen.
llama.cpp zeigt diese Richtung praktisch. Das Projekt beschreibt Unterstützung für LLM- und VLM-Inference in lokalen und Cloud-Umgebungen, darunter CPU, Apple-Plattformen, CUDA, HIP, Vulkan, SYCL und hybride CPU-GPU-Ausführung. Die Dokumentation beschreibt dies als breite Hardware-Unterstützung statt eines einzigen Accelerator-Pfads. Das Release v0.4.1 vom 14. September ergänzte Modellarchitekturen, Rollback für wiederkehrenden State, KV-Cache-Fixes, Arbeiten an JSON-Schemas, JSONL-Logging und Fixes für Speculative Decoding. Das erweitert und stabilisiert die Kompatibilitätsfläche, statt nur ein Modell hinzuzufügen. Release Notes
Warum das jetzt zählt
Die Wahl der Hardware ist zu einer betrieblichen Variable geworden. Du kannst auf einem Laptop entwickeln, für einen internen Dienst einen CPU-Fallback betreiben, GPUs für Workloads mit hohem Volumen einsetzen und am Edge vielleicht eine NPU oder integrierte GPU benötigen. Kapazität, Datenschutzanforderungen, regionale Verfügbarkeit und Incident Response können alle erzwingen, dass Inference an einem anderen Ort läuft.
Ohne Portabilität wird jeder Wechsel zu einer Migration: Modell konvertieren, Runtime ersetzen, Request-Handling neu implementieren, Output-Unterschiede erneut untersuchen und Deployment-Automatisierung umschreiben. Für einen einzelnen Prototyp ist das handhabbar. Teuer wird es, wenn ein Produkt mehrere Umgebungen unterstützt oder sich Hardware-Verfügbarkeit schneller ändert als die Anwendungs-Roadmap.
Das Ziel lautet nicht: „Alles läuft überall.“ Es geht darum, Wahlmöglichkeiten zu behalten. Ein Team kann entscheiden, dass ein bestimmtes Modell in Produktion nur auf einer GPU laufen soll, und trotzdem CPU-Ausführung für lokales Debugging und eingeschränkten Betrieb bereithalten. Wenn Produktschnittstelle und Verifikationsstrategie stabil bleiben, ist das bereits ein Portabilitätsgewinn.
Wie der Stack portabel wird
Am Anfang steht das Modellartefakt: das Paket mit trainierten Gewichten und den Metadaten, die nötig sind, um sie zu interpretieren. Ein portables Artefakt trennt diese Daten von dem gerätespezifischen Code, der die Berechnung ausführt. GGUF ist ein Beispiel aus dem GGML-Ökosystem: ein eigenständiges, erweiterbares Format, das Informationen transportieren soll, die ein kompatibler Executor zum Laden eines Modells benötigt. Spezifikation
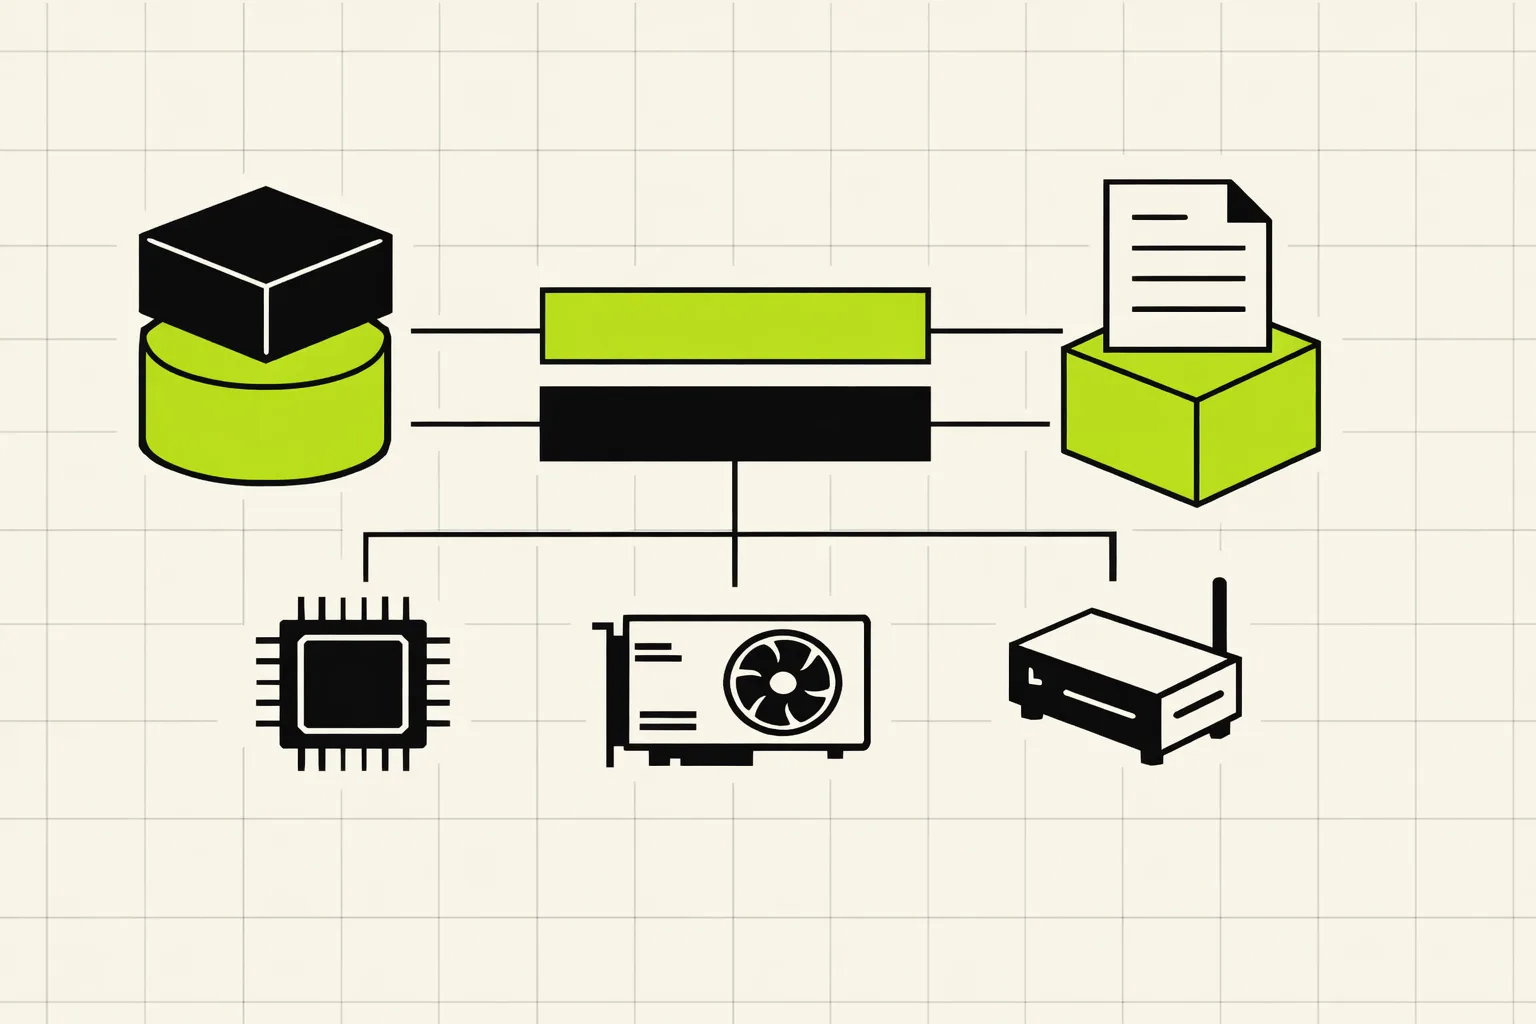
Diese Trennung ist nötig, aber nicht ausreichend. Die Runtime braucht eine Möglichkeit, die Berechnung unabhängig von einem bestimmten Chip auszudrücken und sie dann für ein gewähltes Backend auszuführen oder zu übersetzen. Ein Backend ist die gerätespezifische Implementierungsschicht: CPU-Kernels, GPU-Kernels, eine Hersteller-Runtime oder ein Graph-Compiler. Das OpenVINO-Backend von llama.cpp übersetzt beispielsweise GGML-Computing-Graphs in OpenVINO-Graphs und kompiliert sie für ein Zielgerät. Laut Dokumentation kann dieselbe GGUF-Datei auf Intel-CPUs, GPUs und NPUs laufen, ohne Modell oder übrigen llama.cpp-Stack zu ändern. OpenVINO-Backend-Dokumentation
Danach folgt Runtime Dispatch: Die Auswahl eines verfügbaren Backends und Geräts erfolgt zur Laufzeit, statt sie im Anwendungscode fest zu verdrahten. llama.cpp dokumentiert simultane Backend-Builds, Laufzeit-Geräteauswahl und dynamisch geladene Backends, mit denen ein Binary auf Maschinen mit unterschiedlichen GPUs arbeiten kann. Build-Dokumentation Das beseitigt Plattformunterschiede nicht; es verschiebt die Gerätewahl hinter eine kontrollierte Grenze.
Auch Quantization gehört in diese Grenze. Dabei werden Gewichte und manchmal Aktivierungen mit weniger Bits dargestellt, um Speicherbedarf zu senken und in manchen Fällen den praktischen Durchsatz zu verbessern. Das ist nicht bloß Komprimierung. Die Präzisionsformate, die ein Backend ausführen kann, seine Konvertierungen und das daraus resultierende Verhalten sind Teil des Deployment-Vertrags. Ein Gerät, das ein Modell laden kann, aber nicht die vorgesehene Quantization ausführt, ist kein gleichwertiges Ziel.
Zuletzt braucht die Anwendung eine stabile Serving-Schnittstelle. Das kann eine Library-Grenze, eine Kommandozeilenintegration oder eine kompatible Server-Schnittstelle sein. Entscheidend ist, dass Clients dieselbe Request-Form senden und dieselbe Art von Antwort erhalten, während die Implementierung CPU, GPU oder ein anderes unterstütztes Ziel auswählt. Das ist API-Portabilität. Sie hängt mit Inference-Portabilität zusammen, ist aber kleiner: Eine stabile API sagt wenig darüber aus, ob sich Artefakt und Runtime darunter verschieben lassen.
Einfach gesagt: Halte vier Entscheidungen getrennt: welches Modell du verwendest, wie es gespeichert wird, welches Gerät es ausführt und wie der Rest des Produkts es aufruft. Erst ihre Vermischung macht aus einem Hardwarewechsel eine Neuentwicklung.
Was es nicht ist
Inference-Portabilität ist nicht Performance-Portabilität. Letztere bedeutet, auf verschiedenen Plattformen eine akzeptable Effizienz zu erhalten. Eine portable Runtime kann auf CPU und GPU funktionieren, dabei aber völlig unterschiedliche Latenz, Durchsatz, Speichernutzung oder Energieverbrauch haben. Funktionale Verfügbarkeit ist kein Service-Level-Ziel.
Sie ist auch nicht Modellkonvertierung. Konvertierung transformiert Gewichte oder Graph-Repräsentationen für eine Ziel-Runtime. Sie kann für Portabilität nötig sein, aber eine abgeschlossene Konvertierung sagt nichts über den Rest des Stacks: unterstützte Operatoren, Fehlerbehandlung, Tokenizer-Kompatibilität oder strukturierte Ausgabe.
Und sie ist nicht Inference Serving insgesamt. Serving umfasst außerdem Scheduling, Skalierung, Mandantentrennung, Observability, Isolation, Authentifizierung und Deployment. Portabilität ist eine Architektureigenschaft innerhalb dieses größeren Systems. Eine Runtime kann portabel sein und trotzdem im großen Maßstab kaum sicher betreibbar sein.
Ein praktisches Software-Engineering-Beispiel
Betrachte einen hypothetischen internen Code-Search-Assistenten. Er erzeugt strukturierte Ergebnisse mit Repository-ID, Dateipfaden, gefundenen Symbolen und einer kurzen Erklärung. Developers verwenden ihn lokal; ein zentraler Dienst bearbeitet größere Indizes; für sensible Repositories kann eine isolierte Umgebung erforderlich sein.
Ein portables Design beginnt mit einem expliziten Vertrag. Die Anwendung erfasst Modellrevision, Artefaktformat, Tokenizer-Revision, unterstützte Quantization, Input-Limits, Output-Schema und Hardwareklasse des Ziels. Retrieval und Autorisierung bleiben außerhalb der Modell-Runtime. Die Inference-Komponente erhält vorbereiteten Context und liefert ein Schema-validiertes Ergebnis zurück, statt selbst Datenbank-Credentials oder Repository-Zugriff zu besitzen.
Das Team definiert dann drei unterstützte Ziele: einen CPU-Pfad für Developers, einen GPU-Service und einen eingeschränkten On-Premises-Pfad. Jedes Ziel verwendet dieselbe modellsichtige Schnittstelle, besitzt aber ein eigenes Ressourcenprofil und eine eigene Backend-Konfiguration. Das GPU-Ziel kann die normale Produktionswahl sein; die CPU dient Entwicklung und Betriebsfähigkeit, nicht demselben Durchsatz-Ziel.
Ein Release Candidate läuft mit einer Matrix repräsentativer Prompts auf jedem unterstützten Ziel. Geprüft werden gültige Schema-Ausgabe, korrekte Repository-Grenzen, vollständige Antworten, Speicherlimits, Latenzverteilung und Fehler bei begrenztem Context Window. Bei generativen Modellen solltest du Ergebnis-Eigenschaften vergleichen, statt byteidentischen Text zu erwarten. Wenn der Assistent einen KV-Cache führt – gespeicherten Attention-State, der erneute Berechnung früherer Token vermeidet –, müssen Tests auch fortgesetzte oder verlängerte Interaktionen abdecken, weil sich State-Handling zwischen Implementierungen unterscheiden kann.
Die Deployment-Policy kann nun entscheiden, wo ein Request läuft, ohne die aufrufende Anwendung zu ändern. Verantwortbar wird diese Entscheidung aber nur, weil die Ziele klassifiziert und getestet sind. „Unterstützt“ sollte eine dokumentierte Kombination aus Modell, Quantization, Backend, Treiberfamilie und Workload bedeuten – nicht: „Es hat einmal eine Antwort erzeugt.“
Einfach gesagt: Behandle jeden Hardwarepfad wie einen unterstützten Browser: Lege fest, was er können muss, teste echte Nutzerabläufe darauf und behaupte keine Unterstützung mehr, wenn die Prüfungen scheitern.
Wo Portabilität bricht
Die erste Falle ist die Annahme identischer Outputs. Reihenfolge von Floating-Point-Operationen, Kernel-Implementierungen, Quantization, Tokenisierung und State-Management können numerische oder Verhaltensabweichungen erzeugen. Für Zusammenfassungen kann das harmlos sein, für einen JSON-Workflow oder einen sicherheitsrelevanten Klassifikator aber nicht.
Die zweite Falle ist ungleichmäßige Backend-Abdeckung. Die Anleitung von llama.cpp für neue Modellarchitekturen verlangt Unterstützung auf wichtigen Backends wie CUDA, Metal und CPU, weist aber darauf hin, dass manche Backends nicht alle Operationen unterstützen. Architektur-Anleitung Die OpenVINO-Dokumentation nennt außerdem Accuracy Validation, Optimierung, breitere Quantization-Abdeckung und breitere Modellunterstützung als laufende Arbeit. OpenVINO-Backend-Dokumentation
Die dritte Falle besteht darin, eine gemeinsame Datei mit einer gemeinsamen Betriebsumgebung zu verwechseln. Treiber, Binärkompatibilität, verfügbarer Speicher, Gerätepartitionierung, sichere Updates und Modellprovenienz bleiben reale Deployment-Themen. Eine Portabilitätsschicht reduziert Kopplung; sie nimmt dir Verantwortung nicht ab.
Zuletzt kostet Abstraktion. Eine gemeinsame Schicht kann bei Accelerator-spezifischen Fähigkeiten hinterherhinken. Escape Hatches können Performance oder Features zurückbringen, doch jede davon wird zu einem bedingten Pfad, der Tests und Dokumentation braucht.
Was du diese Woche tun kannst
Erstens: Schreibe deinen tatsächlichen Inference-Vertrag auf. Nimm Modellartefakt, Tokenizer, Output-Schema, Tool- oder Serving-Schnittstelle, Quantization, unterstützte Ziele und messbare Akzeptanzkriterien auf. Wenn das nicht in ein kurzes Dokument passt, ist die Abhängigkeitsgrenze vermutlich noch nicht klar genug.
Zweitens: Wähle zwei absichtlich unterschiedliche Ziele, etwa einen CPU-Pfad für Developers und den Produktions-Accelerator. Führe auf beiden dasselbe kleine Evaluation-Set aus. Prüfe Schema-Validität, Task-Ergebnisse, Ressourcenobergrenzen, Latenz und erwartete Fehler. Starte nicht mit allen denkbaren Geräten.
Drittens: Mache Portabilität zu Release-Evidenz. Pflege eine Kompatibilitätsmatrix und hänge ihre Ergebnisse an Modell-, Runtime- und Treiber-Upgrades. Dokumentiere zielabhängige Einschränkungen klar. Ein bestandener Test auf einem Backend darf ein anderes nicht stillschweigend freigeben.
Viertens: Trenne Policy von Capability. Lass die Deployment-Konfiguration ein Ziel nach Speicher, Datenschutz, Verfügbarkeit und Performance-Anforderungen auswählen, während das Anwendungsverhalten stabil bleibt. So wird Fallback zu einer expliziten Entscheidung statt zu einem Code-Fork im Notfall.
Der Gewinn ist keine Hardware-Touristik. Du kannst eine fundierte Hardware-Änderung vornehmen, wenn Produktanforderungen sie verlangen – und weißt dabei genau, was sich geändert hat.