Ein Model mit Tool-Nutzung übergibt deiner Anwendung keinen sauberen Funktionsaufruf. Es erzeugt Token: einen Stream, der normalen Text, Reasoning-Marker, einen Tool-Namen, strukturierte Argumente sowie fehlerhafte oder unvollständige Fragmente enthalten kann. Diesen Stream als Prosa mit etwas eingebettetem JSON zu behandeln, ist eine verlockende Abkürzung. Genau dort werden Agent-Systeme jedoch oft unbemerkt unzuverlässig.
Protokollbewusstes Output Parsing ist die Disziplin, generierten Output an der Inference-Grenze als Protokoll zu behandeln. Statt zu fragen: „Können wir irgendwo in dieser Antwort JSON finden?“, fragt sie, was jeder Teil des Streams bedeutet, in welchem Zustand sich die Antwort befindet und ob der Übergang zu einer Tool-Anfrage vollständig genug ist, um zu handeln. Der Parser erkennt Bereiche wie Reasoning, sichtbaren Inhalt, eine Tool-Call-Hülle, einen Tool-Namen, Argumente und das Nachrichtenende. Anschließend überführt er sie in eine einheitliche Repräsentation für die Anwendung.
Dieser Unterschied zählt, weil Textformatierung zu Control Flow wird, sobald ein Model eine Datenbankabfrage ausführen, Infrastruktur deployen oder eine Nachricht versenden kann. Ein Parser, der einen Tool Call mit Reasoning verwechselt, kann einen Agent anhalten. Einer, der ein unvollständiges Argument als fertige Anfrage deutet, kann zu früh ausführen. Einer, der stillschweigend rät, kann eine Änderung des Model-Formats in einen Incident verwandeln.
Einfach gesagt: Eine Model-Antwort ist nicht bloß Text zur Anzeige. Kann sie eine Aktion auslösen, ist sie ein Eingabeprotokoll und braucht dieselbe Sorgfalt wie jede andere nicht vertrauenswürdige Steueranweisung.
Warum das jetzt wichtig ist
Das unmittelbare Beispiel kommt aus der Ling-3.0-Unterstützung von llama.cpp. Ein gemeldeter Fehler trat auf, wenn das Model einen <tool_call>-Marker erzeugte, bevor es seinen Reasoning-Block schloss. Der generische Parser ordnete den gesamten Turn reasoning_content zu und hinterließ keinen nutzbaren Tool Call für den Agent-Loop. Das Ergebnis konnte ein leeres Content-Feld und ein angehaltener Workflow statt einer Tool-Ausführung sein. Der Issue-Bericht dokumentiert diesen Fehlermodus.
Release b11057 fügte einen eigenen Ling-3.0-Parser hinzu. Wenn der erwartete Marker zum Schließen von Reasoning nicht angekommen ist, behandelt er den Beginn eines Tool Calls als implizites Ende des Reasoning. Laut Release Notes kamen Tests für Tool Calls mit offenem Think-Block und für Streaming-Verhalten hinzu. Das ist eine enge Korrektur für ein Format, aber eine allgemeine Systems-Lektion.
Die Lektion lautet nicht, dass jedes Team für jedes Model einen eigenen Parser braucht. Model Output hat vielmehr eine Kompatibilitätsoberfläche. Checkpoints, Chat Templates, Runtime-Versionen und Model-Familien können für scheinbar dieselben Konzepte unterschiedliche Begrenzer und Reihenfolgen verwenden. Je stärker deine Runtime diese Unterschiede hinter einer Tool-API verbirgt, desto ernster muss sie Parsing und Tests an dieser Grenze nehmen.
Deshalb verdient auch Streaming Parsing Aufmerksamkeit. Bei einer nicht gestreamten Antwort kann Code auf die letzten Bytes warten und einmal parsen. Bei einer gestreamten Antwort muss er zwischen „noch nicht genug Information“ und „ungültig“ unterscheiden. Das sind verschiedene Zustände. Werden sie verwechselt, entstehen vorzeitige UI-Updates, abgeschnittene Tool-Argumente oder Tool-Namen, deren Treffer sich mit weiteren Token verändert.
Einfach gesagt: Streaming heißt nicht, jeden Chunk für sich zu parsen. Es heißt, Zustand über Chunks hinweg zu erhalten und zu warten, bis das Protokoll eine Aktion als vollständig ausweist.
Wie diese Grenze funktioniert
Eine robuste Implementierung beginnt damit, das Output-Protokoll aufzuschreiben, auch wenn der Model-Anbieter es nie dokumentiert hat. Definiere Zustände wie Reasoning, sichtbaren Inhalt, Tool-Call-Hülle, Tool-Name, Argumente und Endzustand. Definiere Marker, die jeden Zustand betreten und verlassen. Entscheidend ist außerdem, was bei gebrochener erwarteter Reihenfolge geschieht: Beendet ein Tool-Call-Marker Reasoning implizit, erzeugt er einen Protokollfehler oder bleibt er sichtbarer Text?
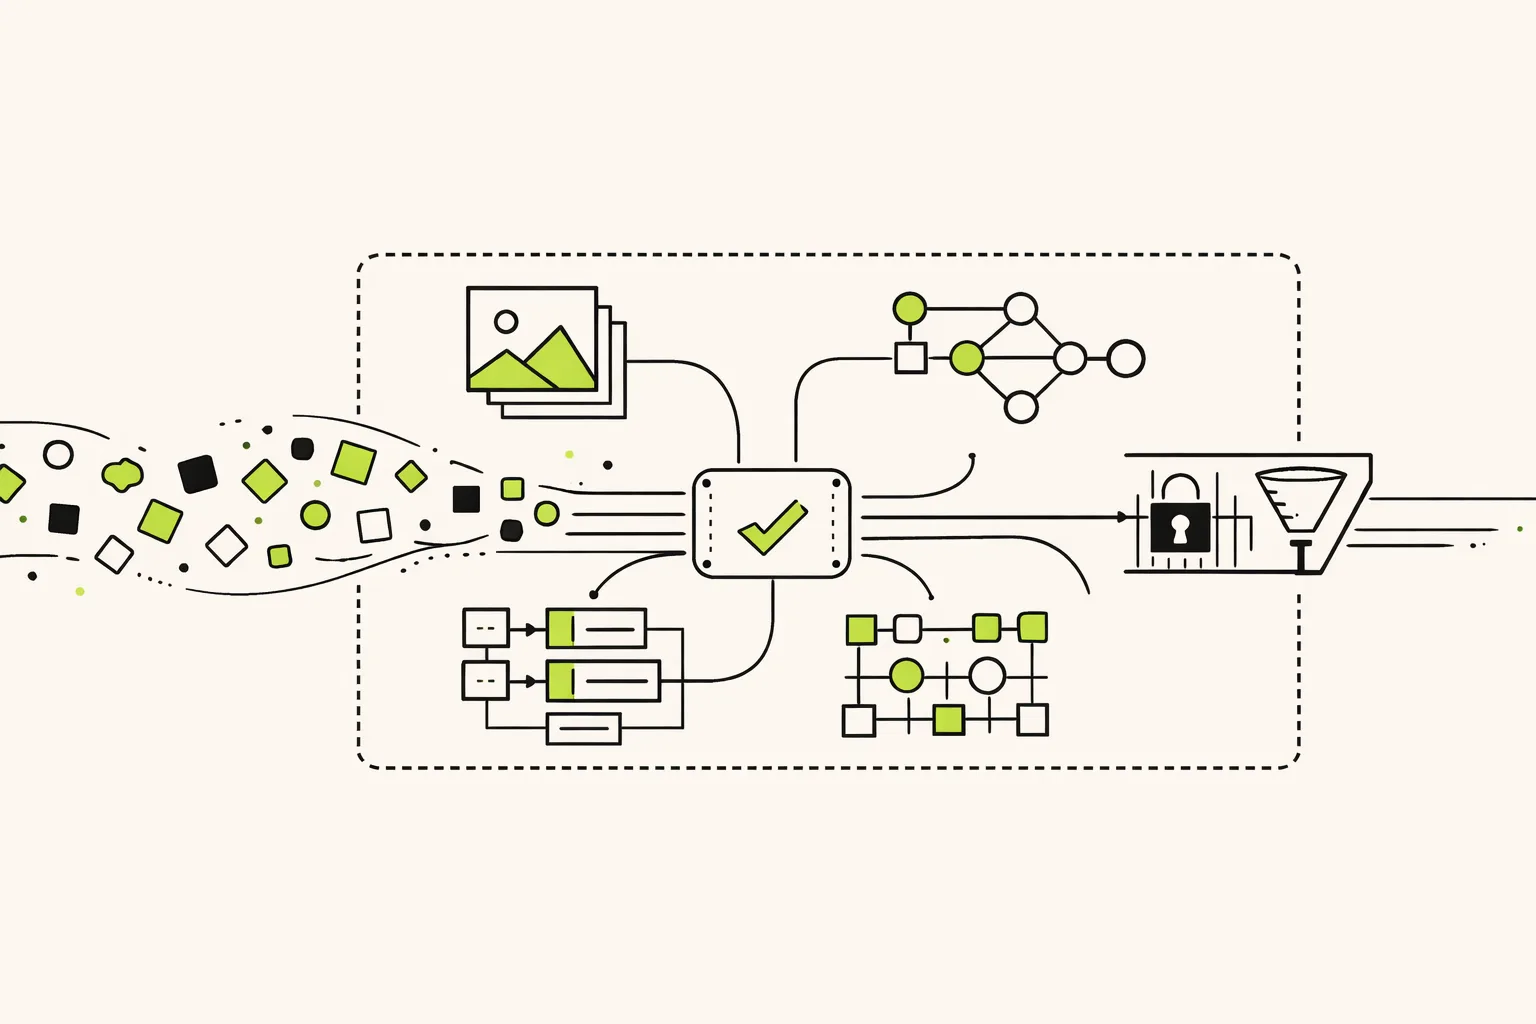
Danach verarbeitet der Parser erzeugte Token schrittweise. Er hält Zustand, statt wiederholt einen regulären Ausdruck auf den bisher gesammelten String anzuwenden. Ein Parser Combinator ist eine Möglichkeit dafür: Kleine Parser für Literale, Alternativen, Sequenzen und verschachtelte Werte lassen sich zu einer Grammatik zusammensetzen und behalten dabei expliziten Zustand und Lookahead. Ein PEG Parser, kurz für Parsing Expression Grammar Parser, ist ein weiterer hilfreicher Ansatz, um geordnete Alternativen und eindeutiges Matching auszudrücken. Der Auto-Parser von llama.cpp kann gerenderte Varianten eines Chat Templates analysieren, Marker für Reasoning, Content und Tools erkennen und einen PEG Parser sowie optional eine Grammatik erzeugen. Die Architektur-Dokumentation beschreibt diesen Ablauf.
Der Parser sollte semantische Bereiche ausgeben, nicht bloß String-Ausschnitte. Semantische Tags versehen geparstes Material mit einer Kategorie wie Content, Reasoning, Tool-Name oder Argument. Die Runtime kann anschließend Normalisierung vornehmen: mehrere Model-spezifische Oberflächenformate werden auf eine stabile interne Struktur wie content, reasoning_content und tool_calls abgebildet. llama.cpp dokumentiert partielles Parsing von Streams, integriertes JSON Parsing und AST-Erzeugung mit semantischen Tags. Außerdem beschreibt es reinen Content, JSON-artige Calls und Formate, bei denen Tool-Argumente separate Einheiten sind, etwa XML oder Pseudo-Funktionsaufrufe. Gerade diese Formate zeigen, warum ein einzelner JSON-Extractor nicht genügt.
Erst nachdem ein vollständiger Call normalisiert wurde, sollte die Runtime die Argumente parsen und Schema Validation anwenden. Schema Validation prüft, ob Daten die erwartete Struktur und die erwarteten Typen besitzen. Sie kann nicht entscheiden, ob delete_project angemessen ist, ob der Aufrufer berechtigt ist oder ob eine plausibel aussehende Kennung auf den richtigen Mandanten zielt. Das sind spätere Prüfungen durch Policy und Tool Dispatch.
Einfach gesagt: Entscheide zuerst, was das Model ausgegeben hat. Prüfe dann, ob die Argumente die richtige Form haben. Erst danach entscheidest du, ob die angeforderte Aktion erlaubt ist.
Diese Reihenfolge ist wichtig. Tool Calls sind Anfragen, keine Berechtigung. Parsing stellt fest, dass das Model eine vollständige Anfrage gestellt hat; Autorisierung entscheidet, ob es diese Fähigkeit verwenden darf; die Ausführung erzeugt den Seiteneffekt. Werden diese Verantwortlichkeiten in einem Schritt „parsen und ausführen“ vermischt, sind Fehler schwerer zu beobachten und einzudämmen.
Was es nicht ist
Protokollbewusstes Parsing überschneidet sich mit mehreren nützlichen Techniken, ersetzt sie aber nicht.
Es ist nicht Constrained Decoding. Constrained Decoding begrenzt, was ein Model während der Generierung ausgeben darf, etwa durch das Erzwingen einer Grammatik oder JSON-Struktur. Das kann fehlerhaften Output reduzieren, nimmt dir aber nicht die Interpretation Model-spezifischer Reasoning- und Tool-Marker, den Umgang mit partiellen Streams oder die Unterstützung alter und nicht eingeschränkter Models ab. Nutze beides, wenn möglich: Constraints verkleinern den Eingaberaum; Parsing verarbeitet das eintreffende Protokoll.
Es ist nicht gewöhnliches JSON Parsing. JSON Parsing beginnt erst, nachdem du einen vollständigen JSON-Wert zuverlässig gefunden hast. Ein Model kann XML-artige Hüllen, Pseudo-Funktionssyntax, mehrere Calls oder einen Tool Call zwischen anderen Kategorien ausgeben. Der Boundary-Parser entscheidet zunächst, welche Bytes überhaupt Argumente sind.
Es ist nicht das Rendern eines Chat Template. Ein Chat Template baut den Prompt und den Generierungskontext; Output Parsing interpretiert die Antwort. Beide Vorgänge können zusammenhängen – der Auto-Parser von llama.cpp untersucht Template-Varianten –, aber sie lösen entgegengesetzte Richtungen des Austauschs. Ein Template ist kein Beweis dafür, dass ein Model die erwartete Antwortstruktur einhält.
Und es ist kein Grund, rohes Reasoning für Nutzer sichtbar zu machen. Die Runtime kann Reasoning, sichtbaren Content und Aktionsanfragen als getrennte semantische Kategorien halten. Die Produkt-Policy kann dann entscheiden, was aufbewahrt, angezeigt oder verworfen wird, ohne dass der Tool Executor Bedeutung aus Darstellungstext erschließen muss.
Ein praktisches Engineering-Beispiel
Stell dir einen internen Release-Assistenten mit zwei Tools vor: get_deployment_status und roll_back_release. Das Model darf Deployment-Status prüfen, doch ein Rollback benötigt zusätzlich eine Policy-Prüfung und einen Approval-Schritt. Während es einen Call vorbereitet, streamt der Assistent seine Antwort in eine UI.
Eine fragile Implementierung sucht nach dem ersten Tool-Marker, nimmt Text bis zum nächsten Marker, ruft JSON.parse auf und dispatcht. Sie scheitert, wenn der Tool-Name als roll_back_ ankommt und später zu roll_back_release wird; wenn sich das JSON-Objekt über Chunks verteilt; wenn eine markerähnliche Folge in einem String-Argument auftaucht; oder wenn das Model einen Tool Call startet, bevor es einen Reasoning-Bereich schließt.
Eine protokollbewusste Implementierung hält stattdessen eine explizite State Machine. Sie gibt sichtbaren Text nur aus dem Content-Zustand aus. Sie hält einen möglichen Tool Call zurück, bis Hülle, Name und Argumente vollständig sind. Sie validiert Argumente gegen das Schema des ausgewählten Tools, zeichnet für Debugging den Roh-Stream und das Parse-Ergebnis auf und gibt den normalisierten Call an eine Autorisierungsschicht weiter. Diese darf Statusabfragen sofort erlauben, für einen Rollback aber ein Approval-Token verlangen. Endet der Stream bei unvollständigen Argumenten, ist das ein Protokollfehler und keine Einladung, eine Vermutung zu reparieren und auszuführen.
Es geht nicht darum, Parsing um seiner selbst willen kompliziert zu machen. Es geht darum, jeden irreversiblen Übergang explizit zu machen. In diesem Beispiel sieht der Tool Executor niemals halbfertigen Text, und die UI muss einen schon angezeigten „Call“ nicht zurücknehmen, wenn spätere Token dessen Bedeutung ändern.
Wo es scheitert
Kein Parser kann ein stabiles Protokoll erzeugen, wenn das zugrunde liegende Model keines liefert. Formate können sich über Checkpoints, Quantisierungen, Templates und Runtimes hinweg ändern. Automatische Extraktion aus Templates kann helfen, doch ungewöhnliche Formate brauchen weiterhin Model-spezifische Handler und Kompatibilitätstests. Der Ling-3.0-Fix erinnert konkret daran, dass eine generische Interpretation falsch sein kann, selbst wenn sie für viele ähnliche Models funktioniert. llama.cpp ergänzte einen eigenen Parser, statt sich allein auf den generischen Pfad zu verlassen.
Mehrdeutige Marker sind ein weiteres Problem. Tool-Namen mit gemeinsamen Präfixen, verschachtelte strukturierte Argumente und Begrenzer in quotierten Strings verlangen zustandsbehaftetes Parsing. Die Tests von llama.cpp prüfen ausdrücklich inkrementelles Parsing und verhindern, dass ein kürzerer Tool-Name erkannt wird, bevor ein längerer Name vollständig eingetroffen ist. Das ist eine wichtige Testeigenschaft, kein Implementierungsdetail.
Außerdem gibt es einen unvermeidlichen Latenzkonflikt. Frühe Ausgabe lässt eine Oberfläche reaktionsschnell wirken, doch Tool Dispatch muss auf ausreichend Belege warten. Wähle unterschiedliche Schwellen für unterschiedliche Verbraucher: Eine UI kann bestätigten sichtbaren Text beim Eintreffen erhalten, während ein Tool mit Seiteneffekten nur eine vollständig geparste und schema-valide Anfrage erhält.
Und Parsing ist nie Autorisierung. Ein perfekt geparster Call kann weiterhin gegen eine Geschäftsregel verstoßen, ein Ressourcenlimit überschreiten oder im aktuellen Nutzerkontext unsicher sein. Behandle erfolgreiches Parsing als notwendige, nicht als hinreichende Bedingung für die Ausführung.
Was du diese Woche tun kannst
Beginne mit einer Bestandsaufnahme. Sammle für jedes Model, das ein Tool anfordern kann, echte gestreamte Transkripte: normale Calls, Antworten ohne Call, mehrere Calls, fehlerhafte Argumente, abgeschnittene Antworten, markerähnliche Werte in Strings und Calls vor einem erwarteten Reasoning-Endmarker. Nimm Model- und Template-Version in jedes Fixture auf.
Mache dann die Zwischenrepräsentation explizit. Dein Inference-Adapter sollte Kategorien wie sichtbaren Content, Reasoning, möglichen Tool Call, vollständigen Tool Call und Protokollfehler zurückgeben – nicht ein einziges überladenes Textfeld. Bewahre den Roh-Output neben der normalisierten Repräsentation in einem kontrollierten Debug-Pfad auf, mit einer zu deiner Umgebung passenden Aufbewahrungs-Policy.
Teste schließlich die Grenze auf Token-Ebene. Führe jedes Fixture als vollständigen Buffer und Token für Token oder in kleinen Chunks aus. Stelle sicher, dass das Endergebnis dort identisch ist, wo es identisch sein muss, dass keine unvollständige Anfrage Dispatch erreicht und dass ein mehrdeutiges Präfix nicht als vollständiger Tool-Name gilt. Diese Tests sind besonders wertvoll vor Upgrades von Model, Template oder Inference-Runtime.
Der praktische Maßstab ist einfach: Wenn generierter Text eine externe Wirkung auslösen kann, gehört seine Rahmung in dein Korrektheitsmodell. Behandle sie als versioniertes Protokoll, parse sie bewusst und schlage fehl, wenn der Stream seine Bedeutung nicht eindeutig belegt.