Langlebige Agents legen ein Infrastrukturproblem offen, das gewöhnliche Request-Handler oft verdecken können. Ein Agent benötigt möglicherweise einen großen Dependency-Graphen, Model-Artefakte, statische Konfiguration und Tool-Setup, bevor er sinnvoll arbeiten kann. Wenn jede neue isolierte Session diese Vorbereitung wiederholt, werden Startzeit und Ressourcenverbrauch Teil der Produkterfahrung.
AWS AgentCore Runtime V2 ist ein aktuelles Beispiel. Die Runtime bereitet eine Umgebung einmal vor, erstellt einen Snapshot und stellt diesen vorbereiteten Zustand für neue Instanzen wieder her, statt die Initialisierung erneut auszuführen. AWS meldete in seinem eigenen Testaufbau eine P75-Cold-Start-Latenz von etwa 1,9 bis 2,0 Sekunden für Container-Images von 200 MB bis 2 GB. Das ist eine produktspezifische Messung, keine allgemeine Garantie. Die AWS-Ankündigung ist weniger wegen dieser Zahl interessant als wegen der dahinterstehenden Architekturentscheidung.
Ein beschreibender Name für ein nützliches Muster
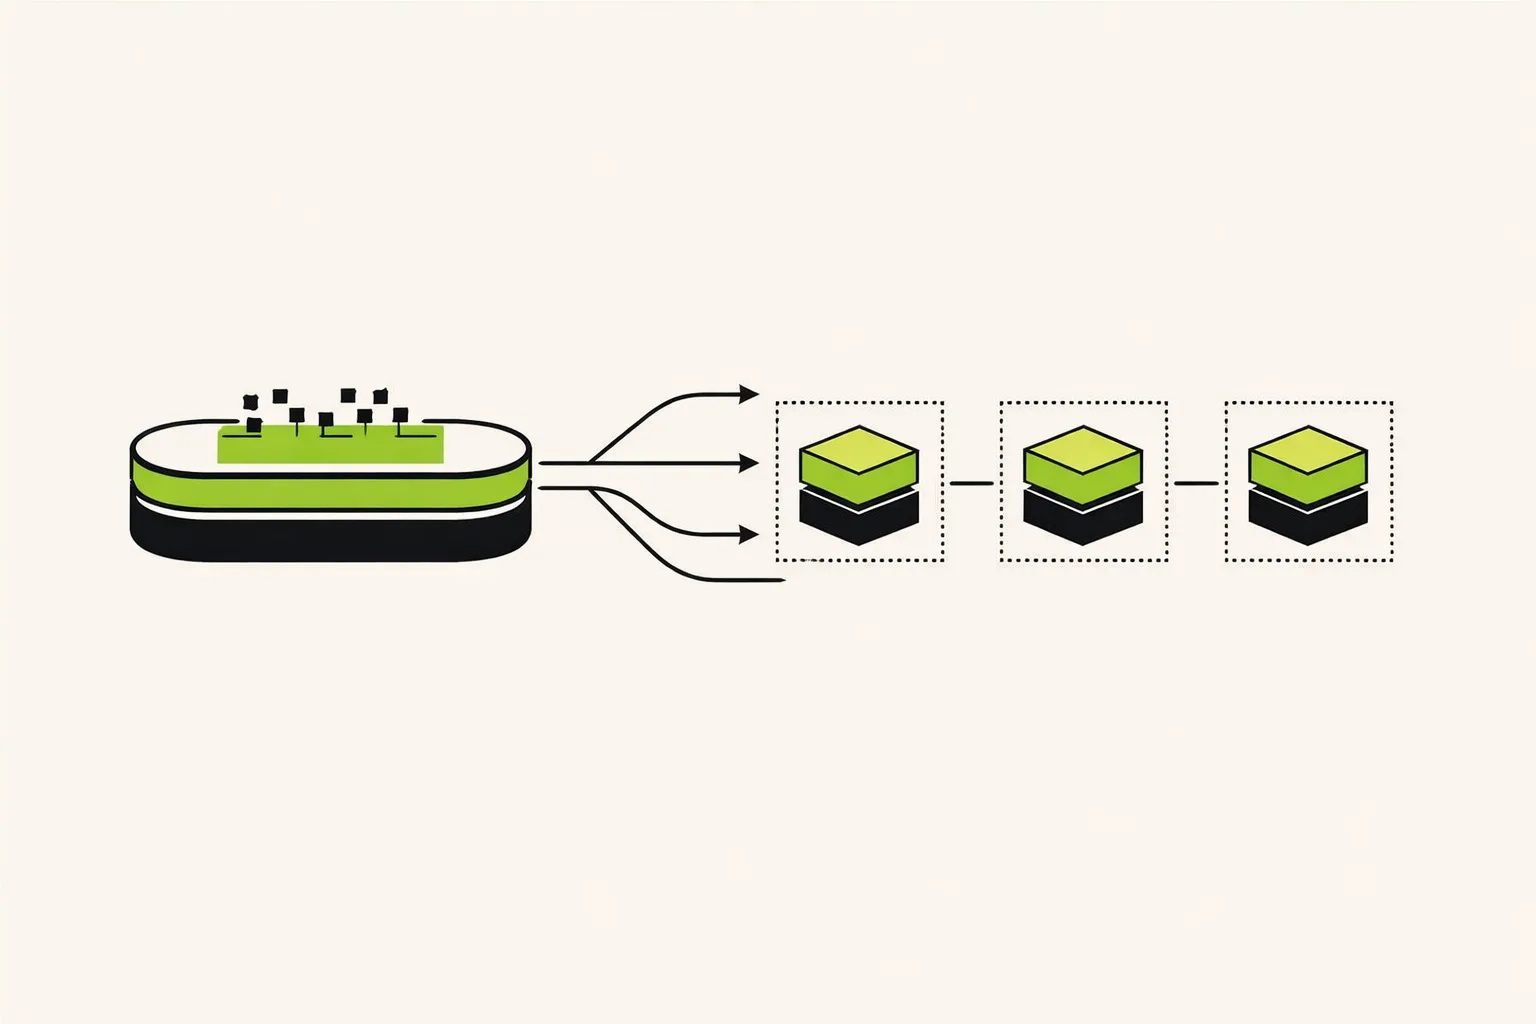
Snapshot-basierte Ausführung ist ein Runtime-Muster: Du initialisierst einen Prozess oder eine Umgebung einmal, erfasst eine wiederherstellbare Darstellung dieses initialisierten Zustands und erzeugst spätere Instanzen durch Wiederherstellung. Das praktische Ziel besteht darin, wiederverwendbare Startarbeit aus dem regulären Startpfad herauszunehmen.
Der Name ist bewusst beschreibend und kein universell standardisierter Begriff. Systemingenieure nennen die breitere zugrunde liegende Technik möglicherweise Checkpoint/Restore; Produktdokumentationen sprechen von Snapshotting, Restore oder Warm-Start-Snapshots. „Snapshot-basierte Ausführung“ meint hier das spezialisierte Production-Muster, bei dem ein absichtlich vorbereiteter Ausgangszustand für viele Instanzen wiederverwendet wird. Checkpoint/Restore ist weiter gefasst: Es kann auch einen laufenden Workload für Migration oder Recovery bewahren.
Einfach gesagt: Du erledigst die teure, wiederholbare Vorbereitung einmal. Du sicherst den vorbereiteten Ausgangspunkt. Neue Worker starten von dort, statt alles neu aufzubauen.
Dieser Unterschied ist wichtig, weil ein Snapshot nicht bloß ein schnellerer Container-Start ist. Ein Container-Image bündelt vor allem Dateisysteminhalt und Startmetadaten. Ein Runtime-Snapshot kann bereits lebendigen, initialisierten Zustand erfassen: geladenen Code, Prozesszustand und weitere Runtime-Ressourcen, die sich rekonstruieren lassen. Das Starten eines Images durchläuft weiterhin den Boot-Pfad der Anwendung; die Wiederherstellung eines Snapshots soll große Teile dieses Pfads umgehen.
Warum das gerade für Agents relevant wird
Ein Agent ist nicht einfach Model-Inference hinter einem HTTP-Endpunkt. Er verbindet häufig einen Model-Aufruf mit Zustand, einer Tool-Schnittstelle, Orchestrierung, Policy-Prüfungen und Session-Handling. Manche Sessions sind interaktiv, andere laufen unbeaufsichtigt weiter. Sie können in Schüben eintreffen, pausieren, fortgesetzt werden oder voneinander isoliert sein müssen.
Diese Workload-Form macht schwankende Initialisierungszeit teuer. Ein Warm Pool löst das, indem er bereits laufende Worker bereithält. Das kann eine schnelle Zuweisung ermöglichen, aber ungenutzte Kapazität bleibt im Speicher und muss vorab dimensioniert werden. Snapshot-basierte Ausführung speichert stattdessen einen kompakten vorbereiteten Ausgangszustand und stellt Instanzen bei Bedarf wieder her. Sie tauscht dauerhaft vorgehaltene Reservekapazität gegen Vorbereitung, Speicherung, Wiederherstellung und sorgfältiges State-Design.
AgentCore V2 verdeutlicht zudem einen verwandten Punkt: Die Startzeit hängt nicht nur von der Image-Größe ab. AWS beschreibt eine Runtime, die eine Umgebung vorbereitet und einen Snapshot erstellt sowie Speicher nach Bedarf zuweist und wieder freigibt, statt den maximal für eine Session belegten Speicher während ihrer gesamten Laufzeit zu halten. Die Runtime-Ankündigung erläutert diese Implementierung. Die übertragbare Lehre lautet nicht, dass jede Plattform gleich funktioniert. Vielmehr verdienen Start, Speicherlebensdauer, Isolation und Session-Dauer ausdrückliche Architekturentscheidungen.
Die Zustandsgrenze ist die eigentliche Arbeit
Die einfache Erzählung – initialisieren, Snapshot erstellen, wiederherstellen – verdeckt die schwierige Frage: Was darf sicher im Snapshot liegen? Die Antwort ist eine Zustandsgrenze, also die Linie zwischen Daten, die während der sinnvollen Lebensdauer eines Snapshots gültig bleiben, und Daten, die nach dem Restore einer Instanz neu entstehen müssen.
Ein sinnvoller Ablauf sieht so aus:
- Du erstellst ein versioniertes Deployment und führst stabile Initialisierung aus. Lade Dependencies, statische Konfiguration und wiederverwendbare Artefakte, deren Werte für die Lebensdauer dieser Version gültig bleiben.
- Du erfasst die initialisierte Umgebung als Runtime-Snapshot. AgentCore dokumentiert dieses Prepare-then-Restore-Modell für Runtime V2. Der Runtime-Leitfaden verknüpft Snapshots außerdem mit Runtime-Versionen und Endpoints.
- Bei Bedarf stellst du eine neue Ausführungsinstanz wieder her.
- Instanz- und Request-spezifische Arbeit erfolgt nach dem Restore: Identität etablieren, aktuelles Autorisierungsmaterial beziehen, dynamische Konfiguration lesen, frische Zufallswerte erzeugen und die Session binden.
- Du nimmst Snapshots zusammen mit dem Deployment-Lebenszyklus außer Betrieb. AgentCore behält alte Snapshots, solange bestehende Sessions sie noch verwenden können, und entfernt sie, sobald sie nicht mehr referenziert werden. Die Lifecycle-Details stehen hier.
Einfach gesagt: Ein Snapshot darf enthalten, was stabil ist. Er darf nicht unbemerkt etwas bewahren, das für die nächste Session neu, aktuell oder eindeutig sein muss.
Die Optimierungsanleitung von AWS macht diese Grenze konkret: Sie trennt Startarbeit, die während der Lebensdauer eines Snapshots stabil bleibt, von Request-Handling, das sich ändert oder abläuft. Die Anleitung ist plattformspezifisch, aber die Frage gilt überall: Welche Werte wären falsch oder doppelt, wenn du den Prozess genau jetzt kopieren würdest?
Credentials sind das offensichtliche Beispiel. Wenn du ein ablaufendes Credential erfasst, kann jede wiederhergestellte Instanz ein bereits veraltetes Secret erhalten. Eine erzeugte Kennung kann zu Kollisionen führen. Ein dynamischer Tool-Katalog kann einer neuen Session eine veraltete Sicht geben. Zeit, Zufallswerte, Session-Identität, externe Verbindungen und Daten aus einem veränderlichen Service solltest du genauso skeptisch behandeln, sofern ihre Semantik nicht ausdrücklich geklärt ist.
Was es nicht ist
Snapshot-basierte Ausführung ist kein gewöhnliches Caching. Ein Cache speichert wiederverwendbare Daten, und Application-Code baut die Ausführung darum herum neu auf. Ein Snapshot stellt einen größeren Teil der Ausführungsumgebung wieder her. Er kann gecachte Daten enthalten, doch sein entscheidendes Merkmal ist die Wiederherstellung vorbereiteten Runtime-State statt der bloßen Rückgabe eines Werts.
Sie ist auch keine Rechtfertigung für eine riesige Startphase. Die Vorbereitung kostet Zeit und besitzt einen Lifecycle. AgentCore dokumentiert, dass die Erstellung und Updates von V2 mehrere Minuten dauern können und die Initialisierung innerhalb des Health-Check-Fensters abgeschlossen sein muss. Diese operative Einschränkung verändert Deployments: Ein schlechter Initialisierungspfad kann scheitern, bevor Production-Traffic ihn überhaupt erreicht.
Auch ein Restore beseitigt nicht jede Latenz. Netzwerk, Routing, externe Authentifizierung, aktuelle Konfiguration und Request-spezifischer Zustand folgen weiterhin danach. Und nicht jede Ressource lässt sich sicher rekonstruieren. Eine aktive Verbindung, ein Device-Handle oder eine kernelabhängige Ressource müssen möglicherweise neu verbunden werden oder passen grundsätzlich nicht in diesen Mechanismus. Die Architektur gelingt, wenn sie diese Grenzen sichtbar macht – nicht, wenn sie so tut, als verschwänden sie.
Beispiel: ein isolierter Repository-Analyse-Agent
Betrachte als hypothetisches Beispiel einen internen Agent, der ein Repository prüft, nachdem ein Pull Request geöffnet wurde. Jeder Job benötigt dieselben Sprachparser, Policy-Regeln, Bibliotheken für Dependency-Graphen und statische Organisationskonfiguration. Der konkrete Job benötigt dagegen einen frischen Repository-Stand, eine Nutzer- oder Service-Identität, aktuelle Policy-Berechtigungen, einen eindeutigen Trace und möglicherweise aktuelle Befunde externer Systeme.
Ohne Snapshots startet jeder Job einen Container, importiert Parser, lädt Regeln, baut wiederverwendbare Indizes auf und beginnt erst dann die eigentliche Prüfung. Mit snapshot-basierter Ausführung kann das Team Parser, statische Regeln und unveränderliche Konfiguration während der Vorbereitung laden. Sie bilden den Ausgangszustand. Nach dem Restore bezieht der Worker aktuelle Credentials, erzeugt den Trace, lädt den angeforderten Stand, liest aktuelle Berechtigungen und führt dann die Prüfung aus.
Das Design macht die Repository-Inhalte nicht zu sicherem Snapshot-Inhalt. Es ordnet sie als Job-spezifischen Zustand ein. Es vermeidet auch einen subtilen Fehler: Kann sich der Tool-Katalog der Policy-Engine ändern, kann das Einfrieren dieses Katalogs in einem Snapshot dazu führen, dass ein Agent Tools nach alten Regeln aufruft. Die Engineering-Entscheidung lautet deshalb nicht „alles snapshotten, was möglich ist“. Sie lautet: „Nur snapshotten, was einen bewusst definierten Gültigkeitsvertrag hat.“
Eine Session verlangt dieselbe Sorgfalt. Session-Historie, die eine Pause überleben muss, gehört in einen dauerhaften Store mit klaren Regeln für Ownership und Aufbewahrung, nicht bloß in vergänglichen Prozessspeicher. Ein wiederhergestellter Prozess kann dann nur die Session-Daten rehydrieren, die er verwenden darf.
Einfach gesagt: Der Snapshot ist eine Fabrikvorlage, kein gespeicherter Kundenjob. Halte kunden-, request- und zeitabhängige Daten außerhalb der Vorlage.
Wo es scheitert
Der gefährlichste Fehlerfall ist gemeinsam genutzter, veralteter Zustand. Er sieht nicht unbedingt wie ein Crash aus. Eine wiederhergestellte Instanz kann gesund wirken und dennoch abgelaufene Credentials, doppelte Kennungen oder alte Konfiguration verwenden. Solche Fehler sind schwierig, weil sie vom Timing abhängen und erst nach einem Deployment, einem Ablauf oder einer Konfigurationsänderung auftreten.
Das nächste Risiko besteht darin, eine Deployment-Version mit einer Snapshot-kompatiblen Version zu verwechseln. Wenn sich Initialisierungsverhalten, Runtime-Dependencies oder Zustandsannahmen ändern, erstelle und validiere einen neuen Snapshot, statt anzunehmen, der alte Ausgangszustand bleibe gültig. Snapshot-Lifecycle ist Teil von Release Engineering, keine unsichtbare Optimierung.
Miss schließlich das Richtige. P75-Cold-Start-Werte eines Anbieters belegen, dass es eine Implementierung gibt; sie sind kein Kapazitätsplan für deinen Service. Deine Ergebnisse hängen von Snapshot-Größe, Restore-Implementierung, Speicherort, Memory Pressure, Hardware-Isolation und der Arbeit ab, die du korrekterweise nach dem Restore lässt. Miss kalte und wiederhergestellte Starts getrennt, dazu Vorbereitungszeit, Bereitschaft nach dem Restore, Speicher, Fehlerrate und Zeit zum Auslaufen alter Versionen.
Was du diese Woche tun kannst
Zeichne zuerst den Initialisierungspfad deines Agents auf. Markiere jede Operation als versionsstabil, instanzspezifisch, request-spezifisch oder extern veränderlich. Diese Einteilung wird wahrscheinlich Arbeit sichtbar machen, die nach den Restore gehört, auch wenn sie beim Booten gerade bequem erscheint.
Baue dann ein kleines Experiment um einen teuren, aber sicheren Initialisierungsschritt. Beginne nicht mit Credentials oder aktiven Verbindungen. Definiere einen Test, der bestätigt, dass eine wiederhergestellte Instanz frische Identität, frische Zufallswerte, aktuelle Konfiguration und eine eigene Session-Grenze erhält. Rotiere bewusst ein Credential und ändere eine dynamische Einstellung zwischen Vorbereitung und Restore; die wiederhergestellte Instanz muss korrekt reagieren.
Mache zuletzt die Snapshot-Bereitschaft beobachtbar. Erfasse Runtime-Version, Snapshot-Identifier, sofern die Plattform ihn bereitstellt, Vorbereitungsdauer, Restore-Dauer und das Alter des Ausgangszustands. Behandle einen Snapshot als deploybares Artefakt mit Kompatibilitätstests und einer Ausmusterungsregel. Genau darin liegt der Wandel: Startzustand wird etwas, das du entwirfst, validierst, versionierst und betreibst.