Ein Tool-nutzender Agent kann überzeugend klingen und trotzdem an seiner eigentlichen Aufgabe scheitern. Er kann behaupten, ein Support-Ticket sei eskaliert, eine Erstattung veranlasst oder ein Incident zugewiesen worden – während der Eintrag im tatsächlichen System unverändert bleibt, auf den falschen Kunden zeigt oder gegen eine Richtlinie geändert wurde.
Genau diese Lücke macht Environment-grounded Evaluation wichtig. Dabei handelt ein Agent in einem kontrollierten, zustandsbehafteten System, und die Evaluation prüft, ob dieses System den geforderten Zielzustand erreicht. Der Text des Agenten ist nicht der wichtigste Beleg. Der veränderte Zustand ist es.
Die Bezeichnung ist nützlich, aber nicht vollständig standardisiert. „Environment-based evaluation“ wird teils weit für jede Evaluation in einer interaktiven Umgebung verwendet. „State-diff evaluation“ ist enger: Dabei werden erwartete und beobachtete Zustandsänderungen verglichen. Dieser Artikel verwendet Environment-grounded Evaluation als Ordnungsbegriff für den breiteren Ansatz: den Workflow ausführen, seine Auswirkungen prüfen und Prozessdaten nutzen, um das Ergebnis zu erklären.
Die NVIDIA-Leitlinie vom 21. September formuliert den Produktionsfall klar: Eine vollständige Agent-Evaluation kann jeden Tool Call ausführen, den Zustand über mehrere Schritte verfolgen und den finalen Weltzustand prüfen, statt nur die Abschlussantwort zu bewerten. Sie trennt außerdem Prozessbewertung von Ergebnisbewertung, weil beide unterschiedliche Fragen beantworten. Die NVIDIA-Leitlinie bedeutet nicht, dass jede Aufgabe eine riesige Simulation braucht. Sie erinnert daran: Wenn ein Agent ein System verändert, muss die Evaluation dieses System beobachten.
Einfach gesagt: Wenn die Aufgabe lautet, „diese Änderung in einem System vorzunehmen“, reicht eine gut klingende Meldung über die angebliche Änderung nicht aus. Prüfe, ob sie wirklich erfolgt ist.
Was wird hier eigentlich bewertet?
Ein Agent ist Software, die ein Modell mit Anweisungen, Context und einem Aktionszyklus verbindet. Er beobachtet eine Situation, wählt einen Tool Call – etwa zum Suchen, Aktualisieren, Erstellen oder Weiterleiten –, erhält eine Beobachtung und entscheidet dann über den nächsten Schritt. Anders als eine einzelne Chat-Antwort entfaltet sich seine Arbeit über Zeit.
Environment-grounded Evaluation beschreibt eine Aufgabe mit vier praktischen Bestandteilen. Zuerst gibt es einen Anfangszustand: Datensätze, Dateien, Nachrichten, Berechtigungen oder andere Fakten, mit denen der Agent startet. Dann folgt eine Schnittstelle, über die er beobachten und handeln kann. Drittens werden erlaubte Fähigkeiten und Einschränkungen festgelegt. Viertens gibt es eine oder mehrere Erfolgsbedingungen, die sich nach der Ausführung prüfen lassen.
Entscheidend ist das Wort „zustandsbehaftet“. Eine Stateful environment merkt sich vorherige Aktionen. Wenn ein Agent ein Ticket erstellt, sollte eine spätere Suche es finden. Aktualisiert er ein Besitzerfeld, muss eine spätere Routing-Aktion den neuen Besitzer sehen. Genau in dieser Rückkopplungsschleife übersehen plausible One-shot-Benchmarks reale Fehler.
Eine Support-Aufgabe könnte beispielsweise mit einem ungelösten Ticket, einem berechtigten Konto und einer schriftlichen Erstattungsrichtlinie beginnen. Erfolg könnte verlangen, dass das Ticket einen Erstattungseintrag mit dem richtigen Betrag enthält, ein Eskalationsfeld auf die korrekte Queue gesetzt ist und eine kundenbezogene Aktualisierung dokumentiert wurde. Das sind beobachtbare Postconditions. Der Agent darf seinen Weg wählen, aber das System muss in einem akzeptablen Zustand enden.
Damit verändert sich die Bedeutung von „korrekt“. Eine natürliche Abschlussantwort kann weiterhin nützliche Evidenz sein: Sie zeigt, was der Agent getan zu haben glaubt, und ob er verständlich kommunizieren kann. Sobald die Aufgabe Nebenwirkungen verlangt, ist sie aber nachrangig. Die entscheidende Frage lautet, ob die geforderten Bedingungen im Terminal state erfüllt sind – also im überprüfbaren Zustand nach Ende des Laufs.
Warum das jetzt wichtig ist
Teams sind besser darin geworden, Modellantworten, strukturierte Function Calls und Prompts zu testen. Diese Prüfungen bleiben wertvoll, doch Agenten schaffen eine größere Fehlerfläche. Ein gültiger Funktionsname beweist nicht, dass der Call angebracht war. Korrekt geformte Argumente beweisen nicht, dass sie den richtigen Datensatz meinen. Und eine Abfolge einzeln plausibler Aktionen beweist nicht, dass Retries, veraltete Beobachtungen oder ein später fehlgeschlagener Call den Workflow nicht unvollständig zurückgelassen haben.
NVIDIA nennt ausdrücklich Task Success Rate, Konsistenz, Tool-Call-Precision, Argument Accuracy, Schritte pro Erfolg und Kosten pro Erfolg als nützliche Metriken. Das Framework ist wichtig, weil es diese Metriken einordnet: Zuerst muss feststehen, ob die Aufgabe ihren geforderten Endzustand erreicht hat. Anschließend helfen Prozessmetriken, Qualität, Effizienz und Fehlermuster zu verstehen.
Aktuelle Forschung zeigt zwei Varianten derselben Verschiebung. Agent-Diff definiert Erfolg über erwartete Änderungen des Umgebungszustands und verwendet eine Sandbox-Ausführungsschicht um Enterprise-API-Schnittstellen. Agent-Diff behandelt einen API-Workflow damit als etwas, das ausgeführt und inspiziert werden muss, nicht bloß vorhergesagt. ToolGym nutzt eine zustandsbehaftete Tool-Umgebung für langlaufende Aufgaben mit mehreren Tools sowie einen Controller, der Unterbrechungen und Fehler einspielen kann. ToolGym nutzt diese Störungen, um Robustheit zu testen, statt den Happy Path vorauszusetzen.
Einfach gesagt: Zu prüfen, ob ein Agent einen sinnvollen nächsten Schritt auswählt, ist nützlich. Für eine Release-Entscheidung ist es nützlicher zu prüfen, ob die gesamte Aufgabe die nächsten zehn Schritte übersteht.
So funktioniert der Evaluationszyklus
Beginne damit, die Aufgabe als testbaren Vertrag statt als vage Absicht zu formulieren. „Bearbeite ein Abrechnungsproblem“ ist keine Evaluation. „Erstelle für dieses Konto und diese Richtlinie die zulässige Erstattung, dokumentiere den Grund, verschiebe das Ticket in die Billing-Queue und ändere keine fremden Datensätze“ kommt dem deutlich näher. Das beschreibt Ausgangsfakten, erlaubte Aktionen, geforderte Ergebnisse und Grenzen.
Danach baust du eine kontrollierte Umgebung. Das kann ein eigens entwickelter Simulator, ein entbehrlicher Test-Tenant oder eine Sandbox um Schnittstellen sein, die den Produktions-APIs ähneln. Welche Variante passt, hängt vom Risiko und vom System ab. Entscheidend sind zurücksetzbarer und inspizierbarer Zustand. Ein Lauf darf den nächsten nicht unbemerkt beeinflussen, und die Evaluation muss feststellen können, was sich verändert hat.
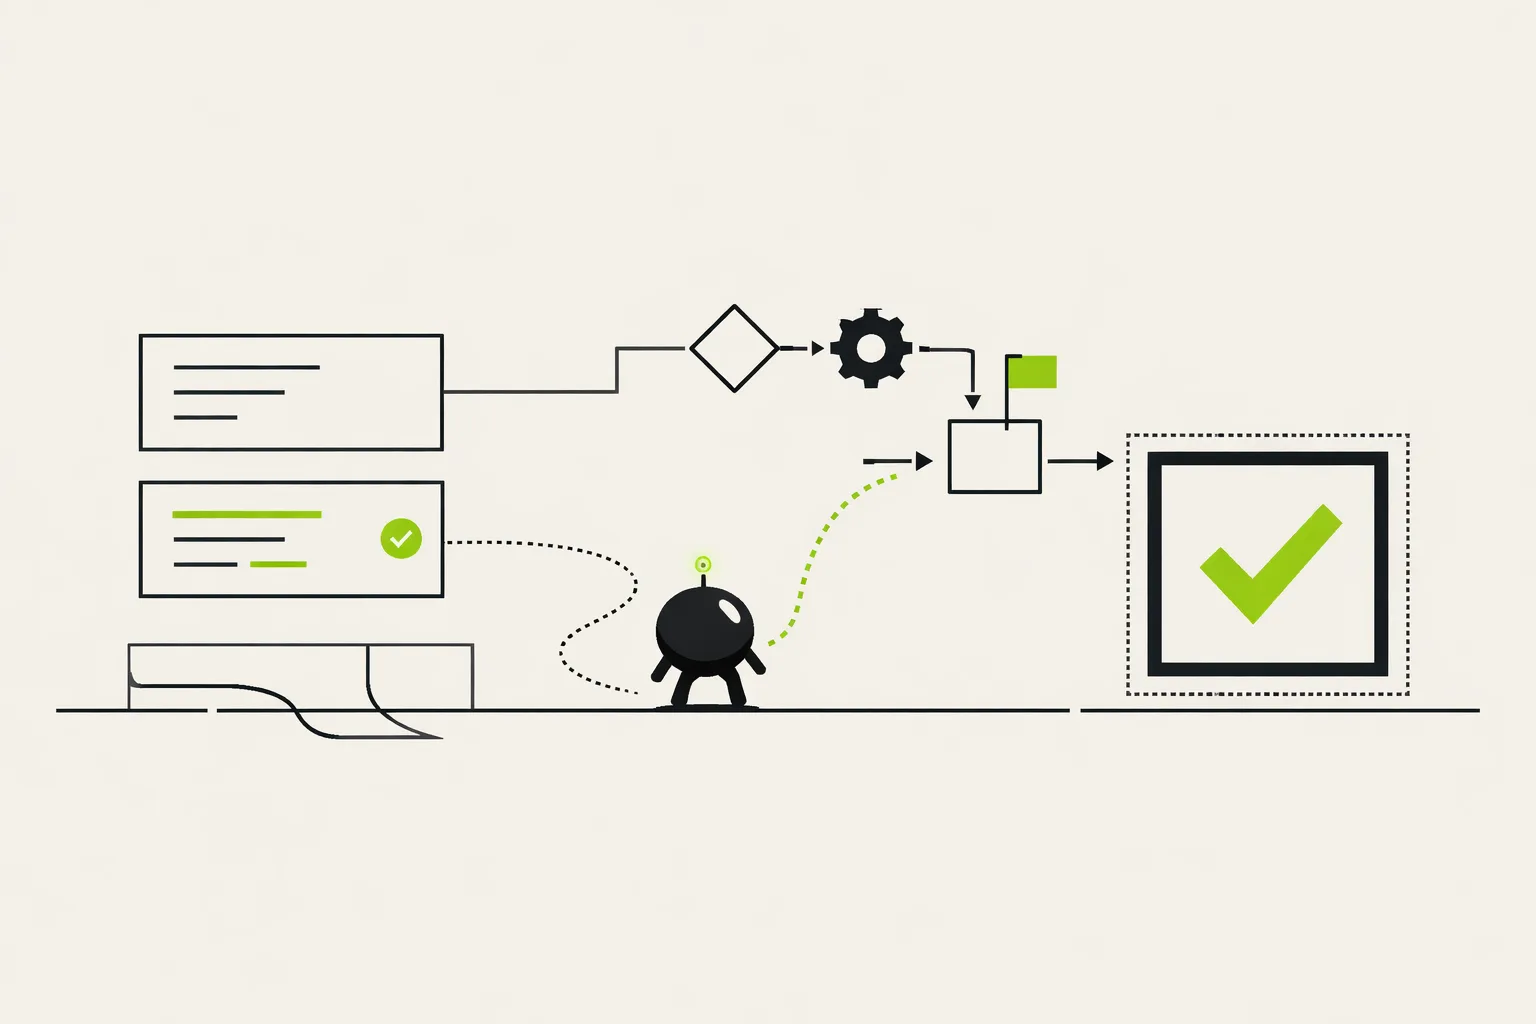
Führe dann den vollständigen Zyklus aus. Der Agent erhält Beobachtungen, wählt Tools, übergibt Argumente, verarbeitet Ergebnisse, wiederholt Aktionen innerhalb seiner Regeln und beendet oder stoppt den Lauf. Speichere die Trajectory: die Abfolge aus Beobachtungen, Entscheidungen, Tool Calls, Ergebnissen und relevanten Zustandsübergängen. Eine Trajectory ist diagnostische Evidenz, aber kein automatischer Erfolgsnachweis.
Nach der Ausführung setzt du einen Verifier ein. Wo möglich, sollte das ein Deterministic verifier sein: explizite Prüfungen von Datensätzen, Dateien, Feldern, Berechtigungen oder Invarianten. Er kann erwartete und beobachtete Zustandsänderungen vergleichen, das Vorhandensein erforderlicher Objekte bestätigen und verbotene Nebenwirkungen erkennen. Manche Aufgaben enthalten subjektive Aspekte, etwa die Qualität einer Kundenantwort. Dafür kann menschliche Prüfung oder ein LLM Judge nötig sein. Diese Methoden sollten aber keine deterministischen Prüfungen beobachtbarer Nebenwirkungen ersetzen.
Berichte schließlich Ergebnis und Prozess getrennt. Die Task Success Rate zeigt, wie oft die geforderten Postconditions erfüllt wurden. Tool-Call-Precision fragt, ob die gewählten Calls angemessen waren. Argument Accuracy prüft, ob ihre Parameter korrekt waren. Schritte und Kosten pro Erfolg beschreiben Effizienz. Konsistenz über wiederholte Läufe zeigt, ob ein Ergebnis verlässlich statt zufällig ist. Diese Metriken ergänzen sich; sie sind nicht austauschbar.
Was es nicht ist
Environment-grounded Evaluation ist nicht bloß Trace-Review. Trace-basierte Evaluation bewertet, was das Modell auf einem aufgezeichneten Pfad gesagt und getan hat. Sie kann eine schlechte Entscheidung, einen fehlerhaften Call oder eine übersehene Anweisung sichtbar machen. Doch ein plausibler Trace beweist nicht, dass eine externe Aktion funktioniert hat. Das Konto kann sich verändert haben, nachdem der Agent es gelesen hat; eine API kann eine Anfrage abgelehnt haben; ein früherer Retry kann ein Duplikat erzeugt haben.
Es ist auch kein statischer Function-Calling-Benchmark. Statische Tests können prüfen, ob ein Modell ein gültiges Schema auswählt oder in einem einzelnen Turn ein Argument richtig füllt. Das bleibt sinnvoll. Die environment-grounded Frage ist weiter: Hat der Workflow nach mehreren Calls und Zustandsübergängen das gewünschte Ergebnis erzeugt?
Ebenso wenig ersetzt der Ansatz Evaluation-driven Development, also die Praxis, Evaluations über Design und Iteration hinweg einzusetzen. Er ist eine konkrete Evaluationsarchitektur innerhalb dieser Praxis. Zwar ähnelt er End-to-End-Integrationstests, doch das Testobjekt ist ein anderes. Ein klassischer Integrationstest führt meist eine bekannte Abfolge aus. Hier wählt ein Agent eine variable, probabilistische Abfolge. Deshalb braucht die Evaluation sowohl Ergebnisprüfungen als auch detaillierte Aufzeichnungen des Wegs dorthin.
Ein praktisches Engineering-Beispiel
Stell dir als hypothetisches Beispiel einen internen Agenten für Incident-Routing vor. Er erhält einen neuen Incident, kann Service Ownership prüfen, On-call-Pläne nachschlagen, ein Tracking-Issue anlegen und den Incident-Datensatz aktualisieren. Eine schwache Evaluation würde fragen, ob seine Abschlussantwort das richtige Team nennt. Das prüft Erkennung und Formulierung, nicht aber die Ausführung.
Ein stärkeres Fixture befüllt eine kontrollierte Umgebung mit einem Incident, einem Ownership-Datensatz, einem On-call-Plan und einem leeren Issue Tracker. Es gibt dem Agenten nur die für die Aufgabe nötigen Lookup- und Update-Berechtigungen. Seine Postconditions verlangen, dass der Incident das korrekte verantwortliche Team und den On-call-Verantwortlichen enthält, genau ein Tracking-Issue auf ihn verweist und kein unbeteiligter Incident verändert wurde.
Führe den Agenten mit diesem Fixture aus. Behauptet er Erfolg, erstellt aber kein Issue, schlägt der Terminal-State-Verifier fehl. Erstellt er wegen einer unklaren Tool-Antwort beim Retry zwei Issues, kann auch eine Invariante den Lauf fehlschlagen lassen. Routet er korrekt, verwendet nach einer simulierten Aktualisierung aber einen veralteten Ownership-Datensatz, zeigt die Trajectory, wo sein Reasoning oder seine Recovery-Regel versagt hat.
Wiederhole dieselbe Aufgabe nun über mehrere Läufe und Varianten: mit einem vorübergehenden Lookup-Fehler, einem verzögerten Update, einem fehlenden sekundären Feld oder einer anderen Reihenfolge zurückgelieferter Datensätze. Das ToolGym-Prinzip kontrollierter Unterbrechungen ist hier relevant: Robustheit sollte als Verhalten unter Bedingungen getestet werden, denen ein Agent begegnen kann, statt sie aus einem sauberen Lauf abzuleiten. Der State Controller von ToolGym ist ein Beispiel für diese Art der Fehlerinjektion.
Einfach gesagt: Der Test muss „der Agent sagte, er habe den Incident geroutet“ und „der Incident wurde genau einmal an die richtige Stelle geroutet“ als unterschiedliche Ergebnisse erkennen können.
Wo der Ansatz an Grenzen stößt
Eine Zustandsprüfung ist nur so gut wie Umgebung und Verifier. Ein fehlerhafter Verifier kann das falsche Resultat belohnen. Eine vereinfachte Umgebung kann eine Aufgabe versehentlich leichter machen als in Produktion, und ein Agent kann kompetent wirken, weil er Artefakte der Evaluation ausnutzt. Behandle die Umgebung daher als Produktions-Testinfrastruktur: versioniere sie, reviewe sie und schreibe auch für sie Regressionstests.
Reale Services bringen ein weiteres Problem: nichtdeterministisches Timing, Rate Limits, veränderliche Daten, Datenschutzbeschränkungen und irreversible Nebenwirkungen. Eine vollständig realistische Umgebung kann teuer oder unsicher sein; eine Simulation kann zu sauber sein. Es gibt keine allgemeingültige Antwort. Nutze die realistischste kontrollierte Umgebung, die für deine Entscheidung gerechtfertigt ist, und benenne klar, was sie nicht abbildet.
Auch binärer Erfolg kann zu grob sein. Manche Aufgaben erlauben mehrere korrekte Wege, andere nur Teilfortschritt, wieder andere brauchen Urteilskraft. Definiere bei Bedarf mehrere akzeptable Postconditions und behalte eine getrennte Kategorie für sichere Teilergebnisse. Presse nicht jeden komplexen Workflow in einen Ja-Nein-Score, nur weil dieser leicht zu visualisieren ist.
Zuletzt können Terminal Checks schädliches Zwischenverhalten übersehen. Ein Agent könnte eine unzulässige Änderung vornehmen und sie später rückgängig machen. Deshalb braucht Ergebnisverifikation Grenzen für die Trajectory: Capability Limits, geschützte Objekte, Policy Checks und die Prüfung wichtiger Aktionen. Erfolg am Ende rechtfertigt keine unsicheren Mittel.
Was du diese Woche tun kannst
Wähle einen Agent-Workflow mit einer konkreten externen Auswirkung. Starte nicht mit dem breitesten oder autonomsten Use Case. Nimm etwas, dessen Erfolg sich prüfen lässt: ein Ticket-Update, eine Repository-Änderung, das Anlegen eines Issues oder eine Routing-Entscheidung.
Schreibe fünf bis zehn Fixtures als Anfangszustand plus Postconditions. Nimm mindestens einen normalen Fall, einen mehrdeutigen Fall, einen Tool-Fehler und einen Fall auf, in dem der Agent einen geschützten Datensatz nicht verändern darf. Halte Reset und Cleanup explizit. Wenn du die Postconditions nicht formulieren kannst, ist die Produktanforderung vermutlich noch nicht testbar.
Instrumentiere den Zyklus so, dass Tool-Inputs, Outputs, Fehler, Timing und Zustandsänderungen unter angemessener Datenbehandlung erhalten bleiben. Erstelle dann einen Release-Report, der mit Task Success beginnt und darunter Prozessmetriken zeigt: Precision, Argument Accuracy, Schritte, Latenz, Kosten und Konsistenz. So wird ein schönes Trace-Dashboard nicht zum Ersatz für einen funktionierenden Workflow.
Nutze Fehler, um das System in der richtigen Schicht zu verbessern. Ein schlechtes Tool-Schema, eine fehlende Beobachtung, eine schwache Retry-Regel, ein unklarer Prompt oder eine unzureichende Berechtigungsgrenze brauchen unterschiedliche Reparaturen. Der Wert einer zustandsbehafteten Evaluation liegt nicht nur in einem strengeren Score. Sie gibt dir eine disziplinierte Methode, diese Fehler voneinander zu unterscheiden.