Ein langlebiger Agent sendet dem Modell selten eine kurze, saubere Anfrage. Er sendet Arbeitsanweisungen, einen Tool-Katalog, Output-Schemas, Policy-Texte, Repository-Auszüge, Conversation History, abgerufene Dokumente und schließlich die Anfrage eines Nutzers. Vieles davon wiederholt sich. Dennoch behandeln viele Teams den vollständig zusammengesetzten Prompt weiterhin als wegwerfbaren Text.
Prompt-Cache-Architektur verfolgt einen anderen Ansatz: Du gestaltest den wiederverwendbaren Anfang einer Inference-Anfrage als explizite Anwendungsgrenze. Stabile Inhalte platzierst du so, dass der Provider sie wiederverwenden kann; wirklich veränderliche Inhalte trennst du davon; anschließend misst du, ob dieses Layout Cache Reads statt wiederholter Verarbeitung erzeugt. Das ist eine Architekturfrage, nicht nur ein Trick beim Schreiben von Prompts.
Der unmittelbare Anlass ist, dass Prompt Caching besser beobachtbar und steuerbar wird. OpenAI dokumentiert Cache-Hit-Monitoring, Retention Modes, Cache-Diagnostik, minimale cachebare Längen und explizite Cache Breakpoints. Die GPT-6-Ankündigung vom 22. September beschreibt außerdem Diagnostik, Breakpoints und Prewarming als Steuerungsmittel für Workloads. Der Prompt-Caching-Leitfaden von OpenAI und das GPT-6-Update machen die betrieblichen Folgen ungewöhnlich konkret.
Was Prompt-Cache-Architektur ist
Ein Modell verarbeitet Eingaben als Tokens: kleine Text- oder strukturierte Inhaltseinheiten. Während es diese Tokens liest, erzeugt es einen Zwischenzustand der Aufmerksamkeit, der häufig KV Cache heißt, kurz für Key-Value Cache. Beim Prompt Caching bewahrt ein Provider diesen Zustand für einen unveränderten Prompt-Präfix auf, also den Anfang der gerenderten Anfrage. Eine spätere Anfrage mit demselben berechtigten Präfix kann den vorhandenen Zustand wiederverwenden, nur den neuen Suffix verarbeiten und trotzdem eine neue Antwort erzeugen. OpenAI beschreibt diesen Mechanismus als Wiederverwendung von Modell-KV-Zuständen für einen unveränderten Prompt-Präfix.
Einfach gesagt: Statt das Modell bei jeder Anfrage dasselbe Betriebshandbuch neu lesen zu lassen, kann Prompt Caching nach dem Handbuch weitermachen – sofern es exakt gleich ist.
Dieses Wort exakt beinhaltet den Großteil der Engineering-Arbeit. Das System erkennt nicht, ob zwei Anweisungen ungefähr dasselbe bedeuten. Es ist ein Präfix-Matching-Mechanismus, der für den gerenderten Request und relevante Einstellungen empfindlich ist. OpenAI dokumentiert ausdrücklich, dass Tools, Structured-Output-Einstellungen, Reasoning Effort, Verbosity, Modellauswahl und Context Management die Wiederverwendung beeinflussen können. Details, die auf Anwendungsebene harmlos wirken, können damit das Cache-Verhalten verändern.
Der Architekturteil besteht in der bewussten Anordnung dieser Details. Stabile Systemanweisungen, Tool-Definitionen, gemeinsame Beispiele und allgemein verfügbare Referenzinhalte gehören vor veränderliche Eingaben. Zeitstempel, Request-IDs, aktueller Kontozustand, nutzerspezifische Policy-Ausnahmen und die aktuelle Nutzeranfrage gehören typischerweise hinter die wiederverwendbare Grenze. Ein Cache Breakpoint ist der für den Provider sichtbare Punkt, an dem ein berechtigter Präfix geschrieben und später nachgeschlagen werden kann.
Warum das jetzt wichtig ist
Bei einer einfachen Chat-Anfrage kann Caching ein Implementierungsdetail sein. Für einen Engineering-Agent kann es das Kosten- und Latenzprofil des gesamten Systems prägen. Ein Coding-Workflow sendet möglicherweise vor jeder Aktion wiederholt einen großen Tool-Katalog, Repository-Vorgaben, Policy-Einschränkungen und ein gemeinsames Aufgaben-Template. Je mehr wiederholte Prefill-Arbeit anfällt, desto wichtiger wird das Request-Layout.
Das bedeutet nicht: „Mache jeden Prompt riesig, weil es Caching gibt.“ Cache Writes, Reads, Provider-Schwellenwerte, Retention-Fenster und Preise zählen alle. Ein langer Präfix mit wenig Wiederverwendung kann ein schlechter Tausch sein. Entscheidend ist die gedankliche Verschiebung: Wiederholter Context ist ein gemeinsames Produktions-Asset mit Lebensdauer, Verantwortlichkeit, Datenschutz-Eigenschaften und messbarer Wirtschaftlichkeit.
Damit ändert sich auch die Bewertung einer scheinbar gewöhnlichen Änderung. Ein angepasstes Tool-Schema verändert das Agent-Verhalten vielleicht kaum, kann aber einen gemeinsamen Präfix ungültig machen. Eine Änderung an der Context Compaction kann das Token-Volumen senken und zugleich die Wiederverwendung zwischen Turns zerstören. Eine Modellmigration kann verändern, was cachebar ist oder wie es abgerechnet wird. Das sind Auswirkungen eines Deployments, nicht nur Auswirkungen eines Prompts.
Einfach gesagt: Eine Prompt-Änderung kann sich jetzt wie eine Performance-Änderung verhalten. Prüfe sie so sorgfältig wie eine Datenbankabfrage oder ein Upgrade einer gemeinsam genutzten Bibliothek.
So funktioniert es Schritt für Schritt
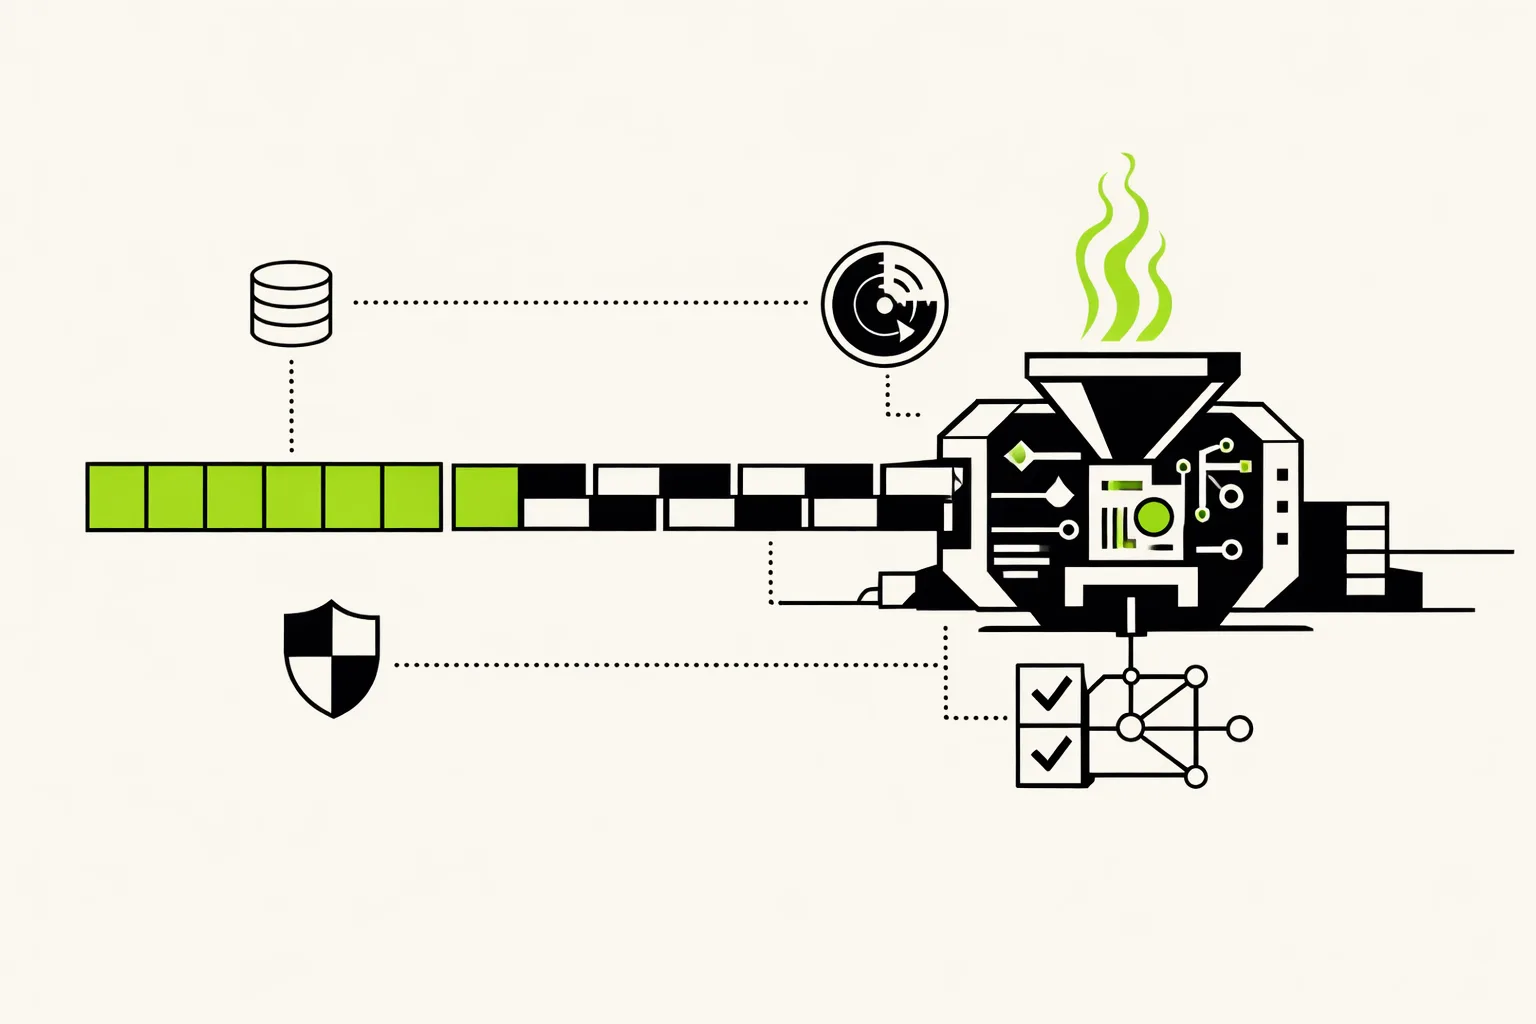
Zuerst baut deine Anwendung einen Request zusammen. Er kann Systemanweisungen, Developer Instructions, Tools, Output-Anforderungen, abgerufene Informationen, frühere Nachrichten und die neue Eingabe verbinden. Entscheidend ist die endgültige serialisierte Reihenfolge, nicht die begrifflichen Kategorien in deinem Code.
Danach verarbeitet der Provider die frühen Tokens und kann einen wiederverwendbaren Eintrag erzeugen, wenn der Präfix seine Anforderungen erfüllt. OpenAI dokumentiert Provider-spezifische minimale cachebare Längen sowie Controls für Breakpoints und Retention. Nimm deshalb nicht an, dass jeder Präfix berechtigt ist oder jeder Request einen Eintrag schreibt. Diese Controls sind als betriebliche Funktionen dokumentiert, nicht als Zusage universeller Wiederverwendung.
Anschließend wird ein späterer Request mit dem früheren Präfix verglichen. Wenn die relevanten vorherigen Inhalte und Einstellungen übereinstimmen, kann der Provider den aufbewahrten Zwischenzustand lesen und mit dem veränderten Suffix fortfahren. Weicht ein früher Abschnitt ab – etwa durch eine umsortierte Tool-Definition oder einen neuen Zeitstempel –, kann der wiederverwendbare Teil an dieser Abweichung enden.
Danach verarbeitet das Modell neue Inhalte und führt Inference aus: Es erzeugt aus dem Request eine neue Ausgabe. Ein Cache Hit reduziert wiederholte Eingabeverarbeitung; er ruft keine zuvor erzeugte Antwort ab. Ergebnisse können weiterhin variieren, und der aktuelle Request kann weiterhin aus üblichen Modell-, Tool- oder Anwendungsgründen fehlschlagen.
Zum Schluss sollte deine Telemetrie zeigen, was passiert ist. Erfasse Cache Reads, Writes, Misses, die effektiv wiederverwendbare Präfix-Länge, Request-Latenz und die Input-Kostenabrechnung. Wenn dein Provider Diagnostik bereitstellt, protokolliere, warum ein Präfix abgewichen ist. So kann ein Team unterscheiden zwischen „das Modell wurde langsamer“ und „unser Deployment hat unbemerkt den gemeinsamen Präfix zerstört“.
Was es nicht ist
Prompt Caching wird oft mit Semantic Caching verwechselt. Semantic Caching speichert eine frühere Antwort und gibt sie zurück, wenn eine neue Anfrage als identisch oder ausreichend ähnlich gilt. Prompt Caching verwendet dagegen einen Zwischenzustand für einen unveränderten Präfix wieder, verarbeitet dann neues Material und generiert erneut. Auch die Anthropic-Dokumentation unterscheidet gecachte Prompt-Präfixe vom Wiederverwenden einer Antwort. Der Mechanismus betrifft also Verarbeitungswiederverwendung, nicht Antwortgleichheit.
Es ist auch nicht Retrieval Caching. Dieses speichert Suchergebnisse, Embeddings, Dokumente oder Datenbankantworten, bevor die Modellanfrage zusammengesetzt wird. Retrieval Caching kann vorgelagerte Arbeit reduzieren; Prompt Caching betrifft die Model-Serving-Schicht nach dem Zusammenbau.
Ebenso wenig ist es dasselbe wie Context Management. Context Management entscheidet, welche History erhalten bleibt, zusammengefasst oder entfernt wird, wenn eine Unterhaltung wächst. Es kann das Token-Volumen senken, aber das Umschreiben alter History kann einen zuvor wiederverwendbaren Präfix ungültig machen. Beide Praktiken müssen gemeinsam gestaltet werden, statt sie getrennt zu optimieren.
Und schließlich ist Prompt-Cache-Architektur nicht allgemeines KV-Memory-Management innerhalb eines Inference Servers. Inference Server behandeln eigene Themen wie aktive Sequences, Batching, Eviction und Hardware-Lokalität. Hier ist die Frage auf Anwendungsebene einfacher: Welchen Request-Präfix können wir stabil halten, und welche für den Provider sichtbare Grenze erlaubt sichere Wiederverwendung?
Ein praktisches Software-Engineering-Beispiel
Betrachte einen hypothetischen internen Repository-Assistenten. Jede Anfrage enthält eine stabile Engineering-Policy, Tools zum Durchsuchen von Code und Lesen von Dateien, ein Output-Schema für Änderungsvorschläge und einen gemeinsamen Repository-Überblick. Danach folgen Metadaten des aktuellen Branches, eine kleine Menge frisch abgerufener Dateien, Conversation History und die Aufgabe des Engineers.
Ein cache-bewusstes Layout platziert Policy, Tool-Katalog, Output-Schema und Repository-Überblick zuerst. Das ist der dauerhafte Präfix. Branch-Metadaten, abgerufene Dateien und die Aufgabe folgen später, weil sie sich voraussichtlich verändern. Wenn der Provider mehrere explizite Breakpoints unterstützt, kann das Team den selten veränderten Tool-Katalog von einem häufiger aktualisierten gemeinsamen Referenzabschnitt trennen; die verfügbaren Controls bleiben Provider-spezifisch. OpenAI dokumentiert explizite Breakpoints und zugehörige Cache Controls.
Das Team sollte einem verlockenden Fehler widerstehen: einen Zeitstempel oder eine Trace-ID aus Bequemlichkeit ganz oben einzufügen. Damit erhält jeder Request einen eigenen Präfix. Lege Observability-IDs, wo verfügbar, in Request-Metadaten ab oder hänge sie nach wiederverwendbare Inhalte an, falls sie Teil der Modelleingabe sein müssen.
Dasselbe Team sollte eine Änderung am Tool-Schema als messbares Release behandeln. Führe vor dem Deployment repräsentative Requests aus und vergleiche Cache-Read-Verhalten, Latenz und Input-Kostenmetriken mit einer Baseline. Nimm nach dem Deployment Stichproben aus dem Produktionsverkehr und beobachte unerwartete Misses. Das ähnelt dem Testen eines verteilten Systems: Korrektheit bleibt notwendig, aber du prüfst auch den Weg, den das System genommen hat.
Für Agents wird diese weitergehende Testdisziplin zunehmend konkreter unterstützt. AWS dokumentiert Evaluations über aufgezeichnete Trajectories und OpenTelemetry Traces sowie CI-Prüfungen für Tool-Auswahl, Tool-Parameter, Reihenfolge und Skill-Verhalten. Die Anleitung macht Prüfungen auf Trajectory-Ebene greifbar. Cache-Metriken ersetzen diese Evaluations nicht; sie ergänzen sie um eine weitere beobachtbare Dimension eines Releases.
Einfach gesagt: Teste, ob der Agent die richtige Arbeit erledigt hat. Prüfe zusätzlich, ob dein Context-Design ihn teure Arbeit unnötig wiederholen ließ.
Wo es scheitert
Exakte Präfix-Wiederverwendung ist absichtlich fragil. Ein Serializer mit anderer Feldreihenfolge, eine nach einem SDK-Upgrade veränderte Standardeinstellung, ein angepasstes Structured-Output-Schema oder ein anderes Modell können den Präfix verändern. Selbst eine scheinbar nützliche Umschreibung von Context kann den Anfang einer Unterhaltung ersetzen und den Großteil der Wiederverwendung entfernen.
Auch ein Cache Hit ist nie garantiert. Verfügbarkeit, Routing, Cache-Berechtigung, Retention und modellspezifisches Verhalten können eingreifen. Ein stabiler Präfix sollte als Optimierungschance gelten, nicht als Abhängigkeit für Korrektheit. Deine Anwendung muss bei einem Miss weiterhin korrekt arbeiten und akzeptable Latenz einhalten.
Datenschutz verdient dieselbe Aufmerksamkeit. Caching kann bedeuten, dass ein Provider Zwischenzustand für eine Zeit aufbewahrt, gemäß Provider-spezifischen Retention- und Datenverarbeitungsregeln. Leite aus einer Cache-Hit-Rate keine Mandantentrennung ab. Prüfe Retention-Verhalten, gegebenenfalls Zero-Data-Retention-Optionen, die geltende Policy des Modells und die Trennung mandantenspezifischen Contexts. Behandle Tenant Isolation als Designanforderung, nicht als Abrechnungsbezeichnung.
Auch die Wirtschaftlichkeit kann scheitern. Ein Cache Write kann mehr kosten als eine ungecachte Eingabe, während spätere Reads günstiger sein können; der Break-even hängt von Wiederverwendungsrate, Präfix-Länge, Preisen und Retention ab. Miss einen realen Workload, statt von einer gelungenen Demo zu extrapolieren. OpenAI stellt explizit Accounting für gecachte Eingaben und betriebliche Cache-Diagnostik bereit.
Was du diese Woche als Senior Engineer tun kannst
Beginne damit, für einen repräsentativen Workload die gerenderte Request-Struktur zu erfassen, wobei du sensible Inhalte schwärzt. Identifiziere den stabilen Präfix, den veränderlichen Suffix und unbeabsichtigte Änderungen wie Zeitstempel, zufällige IDs, nichtdeterministische Tool-Reihenfolge oder neu erzeugte Beispiele.
Mache anschließend den Context-Aufbau explizit. Platziere stabile Anweisungen und Schemas zuerst; füge nutzer- und request-spezifisches Material später an. Führe Cache Boundaries nur über Controls ein, die dein gewählter Provider tatsächlich dokumentiert. Entwirf nicht gegen einen angenommenen Provider-übergreifenden Standard.
Ergänze Dashboards für Cache Reads, Writes, Misses, wiederverwendbare Präfix-Länge, Latenz und Input-Kostenkategorien. Teile diese nur dann nach Workflow, Modell und Mandant auf, wenn diese Segmentierung mit deinem Datenschutzmodell vereinbar ist. Behandle einen starken Rückgang der Hit Rate als Release-Signal, das untersucht werden sollte.
Nimm Cache-Verhalten schließlich in Change Reviews auf. Änderungen an Modellen, Tools, Output-Schemas, Reasoning-Einstellungen, Context Compaction und Prompt-Templates verdienen eine kleine Regression Suite. Das Ziel ist nicht die maximal mögliche Hit Rate um jeden Preis. Es ist ein System, dessen wiederholter Context, Betriebskosten und Datengrenzen absichtlich gestaltet sind.