Ein Streaming-Interface lässt eine KI-Anwendung lebendig wirken: Text erscheint früh, ein Tool Call nimmt Form an, und du kannst eine lange Aufgabe unterbrechen. Diese sichtbare Reaktionsfähigkeit ist nützlich. Es ist aber leicht, sie für ein reines UI-Thema zu halten.
Das ist sie nicht. Sobald ein Modell Text streamen, Tools anfordern, für eine Freigabe pausieren, nach einer unterbrochenen Verbindung wieder verbinden oder ein Ergebnis nach dem letzten sichtbaren Token liefern kann, verarbeitet der Client eine verteilte Interaktion. Die Anwendung muss nicht nur wissen, was eingetroffen ist, sondern auch, was es bedeutet, ob es vollständig ist und was danach sicher geschehen darf.
Genau darum geht es bei Streaming State Management: Zustand, der über einen unvollständigen Event-Stream eintrifft, wird explizit modelliert, akkumuliert, validiert, wiederhergestellt und abgeschlossen. Das ist ein technischer Oberbegriff, kein starr standardisiertes Fachgebiet. Teams sprechen für Teile davon auch von Event Accumulation, resumable Clients, Stream Lifecycle Management oder durable Workflows. Entscheidend ist: Behandle gestreamte Events nicht als Folge von Bildschirmaktualisierungen, sondern als Übergänge in einer State Machine.
Einfach gesagt: Ein Streaming-Client sollte nicht nur fragen: „Was zeige ich jetzt an?“ Er sollte auch fragen: „In welchem Zustand ist diese Operation, und darf ich sicher handeln?“
Warum das jetzt wichtig ist
Eine klassische Request-Response-API setzt eine beruhigende, wenn auch unvollkommene Grenze: Du sendest einen Request, erhältst ein Ergebnis und entscheidest dann, was zu tun ist. Streaming zerlegt diese Grenze in viele Beobachtungen. Ein Textfragment kannst du meist gefahrlos anzeigen. Ein unvollständiges Tool-Argument darfst du nicht ausführen. Ein Verbindungsabbruch kann bedeuten, dass der Server weiterarbeitet – oder dass keine Seite weiß, ob eine ausgehende Nachricht angekommen ist.
OpenAIs Python SDK 3.20.0 hat diese Realität am 28. September 2026 greifbarer gemacht. Das Release ergänzte optionale inkrementelle WebSocket-Snapshots für Text und Tools, bewahrte detaillierte WebSocket-Accumulator-Snapshots und behandelte unsicheres Replay sowie die Behandlung von Caller Queues. Die Release Notes sind implementierungsspezifisch, die Engineering-Lehre gilt aber allgemeiner: Teilfortschritt, Ownership ausgehender Nachrichten und Wiederherstellung sind Korrektheitsfragen, keine reine Produktpflege.
Auch das OpenAI Agents SDK macht den Lifecycle explizit. Seine Dokumentation unterscheidet semantische Events, Abschluss, Abbruch, Unterbrechungen, resumable State und finale Ausgabe. Sie weist außerdem darauf hin, dass nach dem letzten sichtbaren Token noch Events verarbeitet und Nacharbeiten ausgeführt werden können. Die Streaming-Dokumentation und die Dokumentation zu Ergebnissen sprechen deshalb dagegen, „der Text ist zu Ende“ als Abschluss-Signal zu verwenden.
Besonders wichtig wird das, wenn ein Agent Folgen außerhalb eines Chats hat. Ein Coding Agent kann eine Änderung vorbereiten, ein Support Agent eine Kundennachricht entwerfen oder ein Operations Agent eine privilegierte Aktion anfordern. In allen drei Fällen ist der sichtbare Stream nur eine Ansicht einer größeren Operation. Wenn du diese Ansicht mit verbindlichem Anwendungszustand verwechselst, entstehen Race Conditions, doppelte Effekte und schwer nachvollziehbare Wiederherstellungen.
Modelliere die Operation, bevor du ihre Events verarbeitest
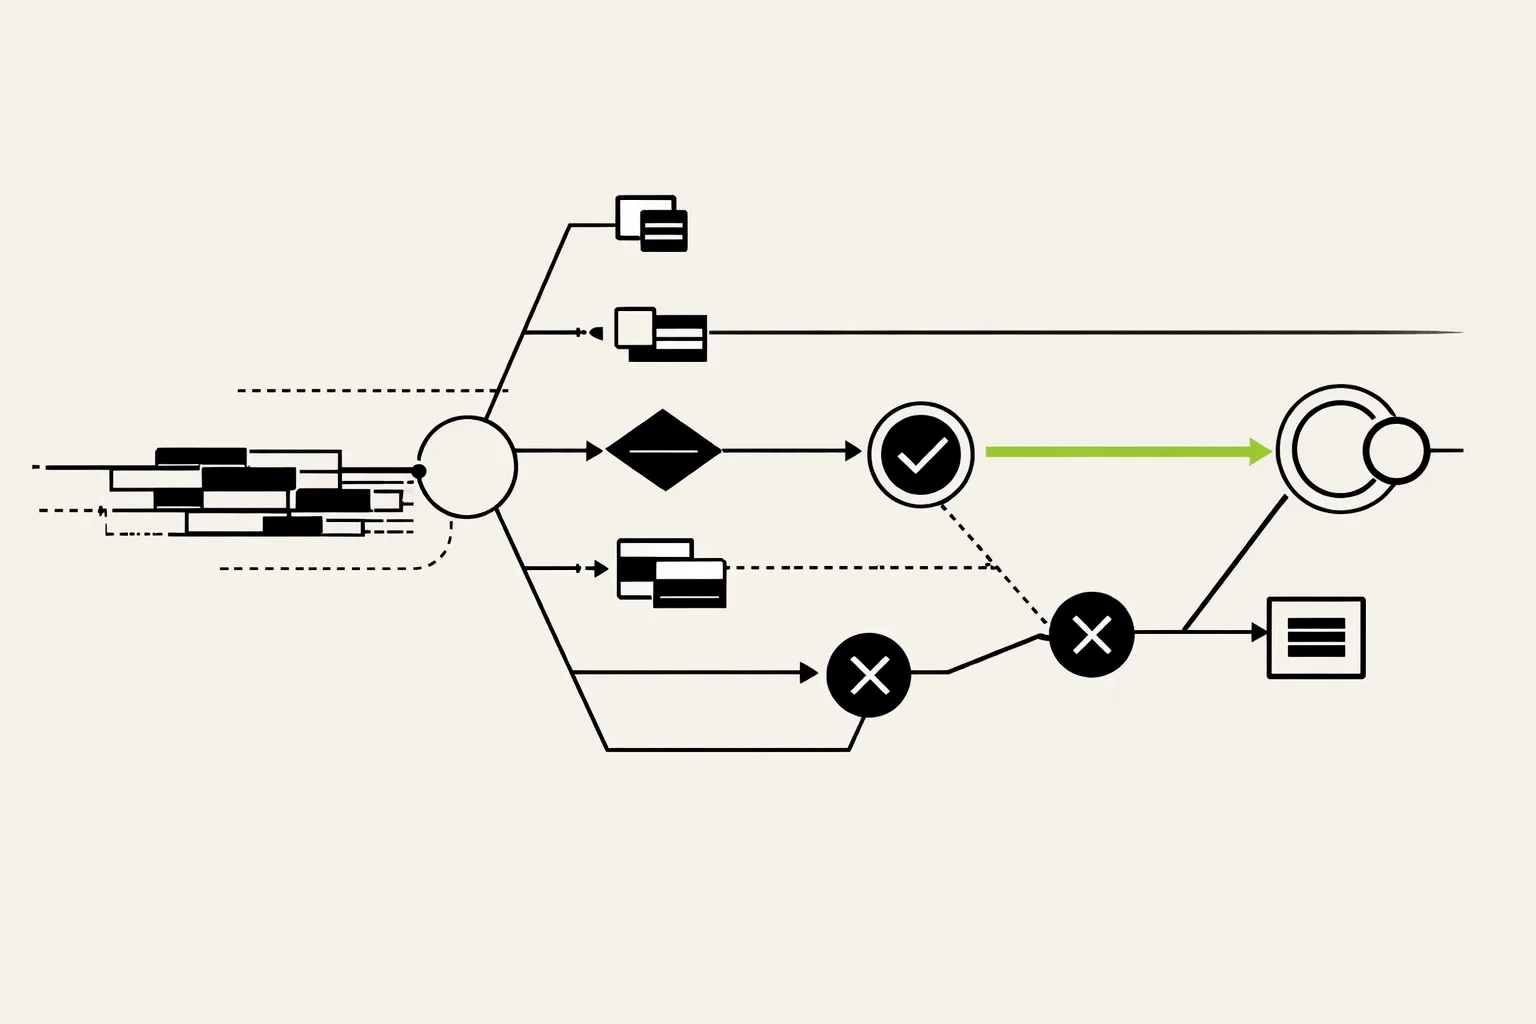
Beginne mit einem Lifecycle, der deiner Anwendung gehört. Die Namen unterscheiden sich, aber ein brauchbares Modell kann connecting, receiving, awaiting_approval, executing_tool, cancelling, cancelled, failed und completed enthalten. Entscheidend ist nicht das Vokabular. Entscheidend ist, zulässige Übergänge explizit zu machen.
Wenn ein Nutzer beispielsweise Stop drückt, kann ein Run in cancelling wechseln. Er sollte nicht automatisch cancelled sein, nur weil das UI keine Tokens mehr rendert. Der Client muss möglicherweise noch terminale Informationen verarbeiten, Ressourcen freigeben, eine ausstehende Tool-Anfrage abgleichen oder einen wiederherstellbaren Datensatz speichern. Ebenso rechtfertigt ein sichtbarer Schlusssatz nicht zwingend den Übergang zu completed, bevor der Provider den finalen Abschluss gemeldet hat und notwendige lokale Nacharbeiten beendet sind.
Akkumuliere Events danach in typisierten Fachzustand. Ein Semantic Event beschreibt etwas, das für die Anwendung Bedeutung hat: ein Message Delta, eine abgeschlossene Tool-Anfrage, eine Freigabeunterbrechung oder ein finales Ergebnis. Ein Transport Event beschreibt die Zustellung: einen WebSocket Frame, einen Reconnect, ein Timeout oder einen Retry. Sie beeinflussen einander, sind aber nicht austauschbar.
Text Deltas kannst du im Regelfall an vorläufigen Anzeigetext anhängen. Tool-Call-Fragmente brauchen einen strengeren Weg: Sammle Kennungen und Argumentfragmente, parse erst nach dem passenden Abschluss-Signal, validiere gegen das Schema des Tools und entscheide dann, ob die Ausführung autorisiert ist. Ein teilweise gebildetes JSON-Objekt zeigt, dass Daten eintreffen. Es ist keine Erlaubnis, eine Datenbank oder eine Deployment-API aufzurufen.
Einfach gesagt: Unvollständiger Text darf angezeigt werden. Aktionen müssen warten, bis die Anwendung einen vollständigen, validierten und autorisierten Request hat.
Ein Snapshot ist die nächste nützliche Grenze. Er hält den aktuellen logischen Zustand fest – etwa akkumulierten Text, bekannte Tool-Call-Felder, die Lifecycle-Position und eine ausstehende Freigabe. So kann ein Client sein Verständnis wiederherstellen, ohne darauf zu vertrauen, dass das Replay roher Frames die Realität rekonstruiert. Die detaillierten Accumulator-Snapshots des SDKs zeigen, warum dieser strukturierte Zwischenzustand wertvoll ist. Die OpenAI-Release-Notes machen Snapshots allerdings nicht zu einer universellen Wiederherstellungsgarantie; sie zeigen, warum Clients explizites Material für die Wiederherstellung benötigen.
Definiere anschließend das Verhalten rund um Verbindungen. Ein Reconnect ist kein semantischer Neustart. Stelle für jede ausgehende Nachricht vier Fragen: Wer besitzt sie jetzt? Wurde sie nur versucht oder bestätigt? Darf sie erneut gesendet werden? Was passiert bei doppelter Zustellung? Die SDK-Fixes zu unsicherem Replay, attempted Sends und Caller Queues zeigen, warum „neu verbinden und alles erneut senden“ unsicher ist. Die betreffenden Release Notes behandeln das als praktisches Transportproblem, nicht als abstrakten Sonderfall.
Definiere schließlich Abschlussbedingungen abhängig vom Provider. Ein finales sichtbares Token, ein Socket Close, ein Tool Result und ein abgeschlossener Run sind unterschiedliche Signale. Baue einen Adapter, der Event-Identitäten und Garantien des Providers auf deinen internen Lifecycle abbildet. So dringen Provider-spezifische Eigenheiten nicht in UI und Fachlogik ein.
Was es nicht ist
Streaming State Management überschneidet sich mit mehreren etablierten Ideen, ist aber kein neuer Name für eine davon.
Event Sourcing ist eine Persistenzarchitektur, bei der ein autoritativer, dauerhafter Event Log Zustand rekonstruiert. Das kann eine starke Basis für Stream-Wiederherstellung sein. Streaming State Management kann aber auch Snapshots, kurzlebigen In-Memory-State oder eine herkömmliche Datenbank verwenden. Sein Kern ist die korrekte Live-Akkumulation und Wiederherstellung, nicht ein vorgeschriebenes Speichermodell.
Es ist zudem enger gefasst als Stream Processing. Stream-Processing-Systeme rechnen meist über fortlaufende Datenströme wie Telemetrie, Klicks, Bestellungen oder Logs. Hier geht es häufig um einen einzelnen interaktiven Run mit ungewöhnlichen Grenzen: unvollständiger Tool Input, Freigabepausen, Abbruch, Verbindungswechsel und ein finales Ergebnis.
Auch durable Execution ist nicht dasselbe. Eine durable Workflow Engine speichert Fortschritt über Fehler hinweg und kann Checkpointing oder Replay-Garantien bieten. Streaming State Management kann in einer solchen Engine liegen, braucht aber weiterhin Regeln für vorläufige Ausgabe, semantischen Abschluss, Wiederherstellung der Verbindung und Seiteneffekte.
Und schließlich reichen Logging und Observability nicht aus. Logs zeigen, was offenbar passiert ist. State Management entscheidet, was die Anwendung als autoritativ akzeptiert, was sie fortsetzen kann und ob sie eine Aktion ausführen darf.
Beispiel: ein gestreamter Deployment Assistant
Betrachte einen hypothetischen internen Deployment Assistant. Er streamt eine Erklärung zu einem vorgeschlagenen Rollout, sammelt Tool-Call-Argumente für eine Deployment-Anfrage und verlangt vor der Ausführung die Freigabe eines Engineers.
Das UI kann Message Fragments sofort anzeigen und als vorläufig markieren. Parallel akkumuliert der Client die Tool-Call-ID und Argumente in typisiertem Zustand. Bricht die Verbindung ab, nachdem der Client die Freigabe gesendet hat, darf er bei einem Reconnect nicht einfach erneut freigeben. Die ursprüngliche Freigabe kann den Service erreicht haben – oder nicht. Der korrekte Wiederherstellungsweg hängt von einer dauerhaften Run-ID, einer Abfrage des aktuellen Run-Zustands, sofern verfügbar, und einer expliziten Policy für eine ungeklärte Bestätigung ab.
Wenn der Run pausiert, speicherst du einen Snapshot mit der ausstehenden Unterbrechung und dem Status der Freigabe. Das Agents SDK dokumentiert dieses Muster: Ein gestreamter Run kann für eine Tool-Freigabe pausieren, zu resumable State werden, eine Auflösung erhalten und fortgesetzt werden. Die Human-in-the-loop-Dokumentation beschreibt diese Provider-spezifische Lifecycle-Fläche; Autorisierung und Wiederherstellungs-Policy bleiben dennoch Verantwortung deiner Anwendung.
Wenn das Deployment-Tool schließlich läuft, braucht das Tool selbst Idempotency: Wiederholte Requests mit derselben Operationsidentität dürfen nicht erneut externe Effekte erzeugen. Ein Snapshot kann Client-Zustand wiederherstellen; er kann ein Deployment nicht genau einmal ausführen. Die Grenze mit Seiteneffekten benötigt ihre eigene Strategie für Deduplizierung oder Idempotency Keys.
Einfach gesagt: Den Bildschirm wiederherzustellen ist nicht dasselbe wie die Operation wiederherzustellen. Jede Aktion mit externen Effekten braucht einen eigenen Plan gegen Duplikate.
Wo es scheitert
Dieses Muster schafft Disziplin, beseitigt aber keine Unsicherheit. Wurde serverseitiger Zustand nicht aufbewahrt, kann ein Client ihn nicht durch Wunschdenken beim Replay rekonstruieren. Das Agents SDK dokumentiert WebSocket-Reuse, Connection Limits, Reconnect-Verhalten und Fälle, in denen lokal verwalteter Zustand nötig ist, um eine Chain nach einem Reconnect wiederherzustellen. Die Dokumentation zum Ausführen von Agents erinnert daran, die Wiederherstellungsgrenzen der konkreten Runtime zu verstehen.
Snapshots können außerdem veralten oder bei weiterentwickelten Event-Schemas inkompatibel werden. Backpressure – der Zustand, dass Events schneller eintreffen, als ein Consumer sie sicher verarbeiten kann – kann dazu führen, dass ein Client zu viel Zustand hält oder irreführende Verzögerungen anzeigt. Und eine Zwischenantwort des Modells kann falsch, revidiert oder unsicher sein, selbst wenn der Transport perfekt funktioniert. Trenne daher strikt vorläufigen Anzeigestatus von verbindlichem Fachzustand.
Der häufigste Fehler ist Selbstüberschätzung. Teams sehen einen kontinuierlichen Textstream, schreiben einen append-only Renderer und halten die Aufgabe für erledigt. Das funktioniert, bis der erste Tool Call, Reconnect, Abbruch oder Freigabe-Workflow aus einem Präsentationsfeature ein transaktionales System macht.
Was du diese Woche tun kannst
Wähle eine gestreamte Route und zeichne ihren Lifecycle. Nimm Verbindungsabbrüche, Nutzerabbrüche, Tool-Freigaben, Provider-Abschluss und Cleanup auf. Kann das Diagramm nicht beantworten, ob ein Tool nach einem Reconnect laufen darf, kann die Implementierung es vermutlich auch nicht.
Trenne deinen Code dann in drei Schichten: einen Transport Adapter, einen typisierten Accumulator und Anwendungspolicy. Der Adapter normalisiert Provider Events. Der Accumulator baut Fachzustand und Snapshots. Die Policy entscheidet über Autorisierung, Retry, Rendering und Seiteneffekte. Diese Trennung macht Provider-Wechsel und Tests deutlich weniger invasiv.
Teste absichtlich unschöne Folgen: doppelte Deltas, fehlende terminale Events, verspätete Tool-Fragmente, Socket Close nach einem attempted Send, Abbruch während eines Tool Calls und einen abgeschlossenen Run, der eintrifft, nachdem das UI fertig wirkt. Erfasse Time to First Delta getrennt von Zeit bis zum semantischen Abschluss und Cleanup. Das sind unterschiedliche Nutzer- und Betriebserfahrungen.
Vor allem: Verwende das Wort „abgeschlossen“ nur für einen definierten, testbaren Zustandsübergang. In gestreamten KI-Systemen verhindert genau diese kleine semantische Disziplin, dass ein angenehmes Live-Interface zu einer unzuverlässigen Steuerungsebene wird.